Zadání
SHIFT Studio je lokální studio pro dabing videa pomocí umělé inteligence pro Macy s Apple Silicon a Windows.
Dabing pomocí AI obvykle vyžaduje celou sadu modelů: pro rozpoznávání řeči, překlad, syntézu hlasu, klonování hlasu a oddělení hlasu od hudby. Každý z nich je třeba najít, nainstalovat, přizpůsobit vlastnímu hardwaru a propojit s ostatními, což je práce pro inženýra, nikoli pro tvůrce videí. Cloudové služby tento problém řeší, jsou ale placené, časově omezené a vyžadují nahrávání materiálů na cizí servery. Cílem projektu bylo zpřístupnit dabing lidem bez technických znalostí: stáhnou si jediný program a pak už jim stačí přetáhnout video do okna.
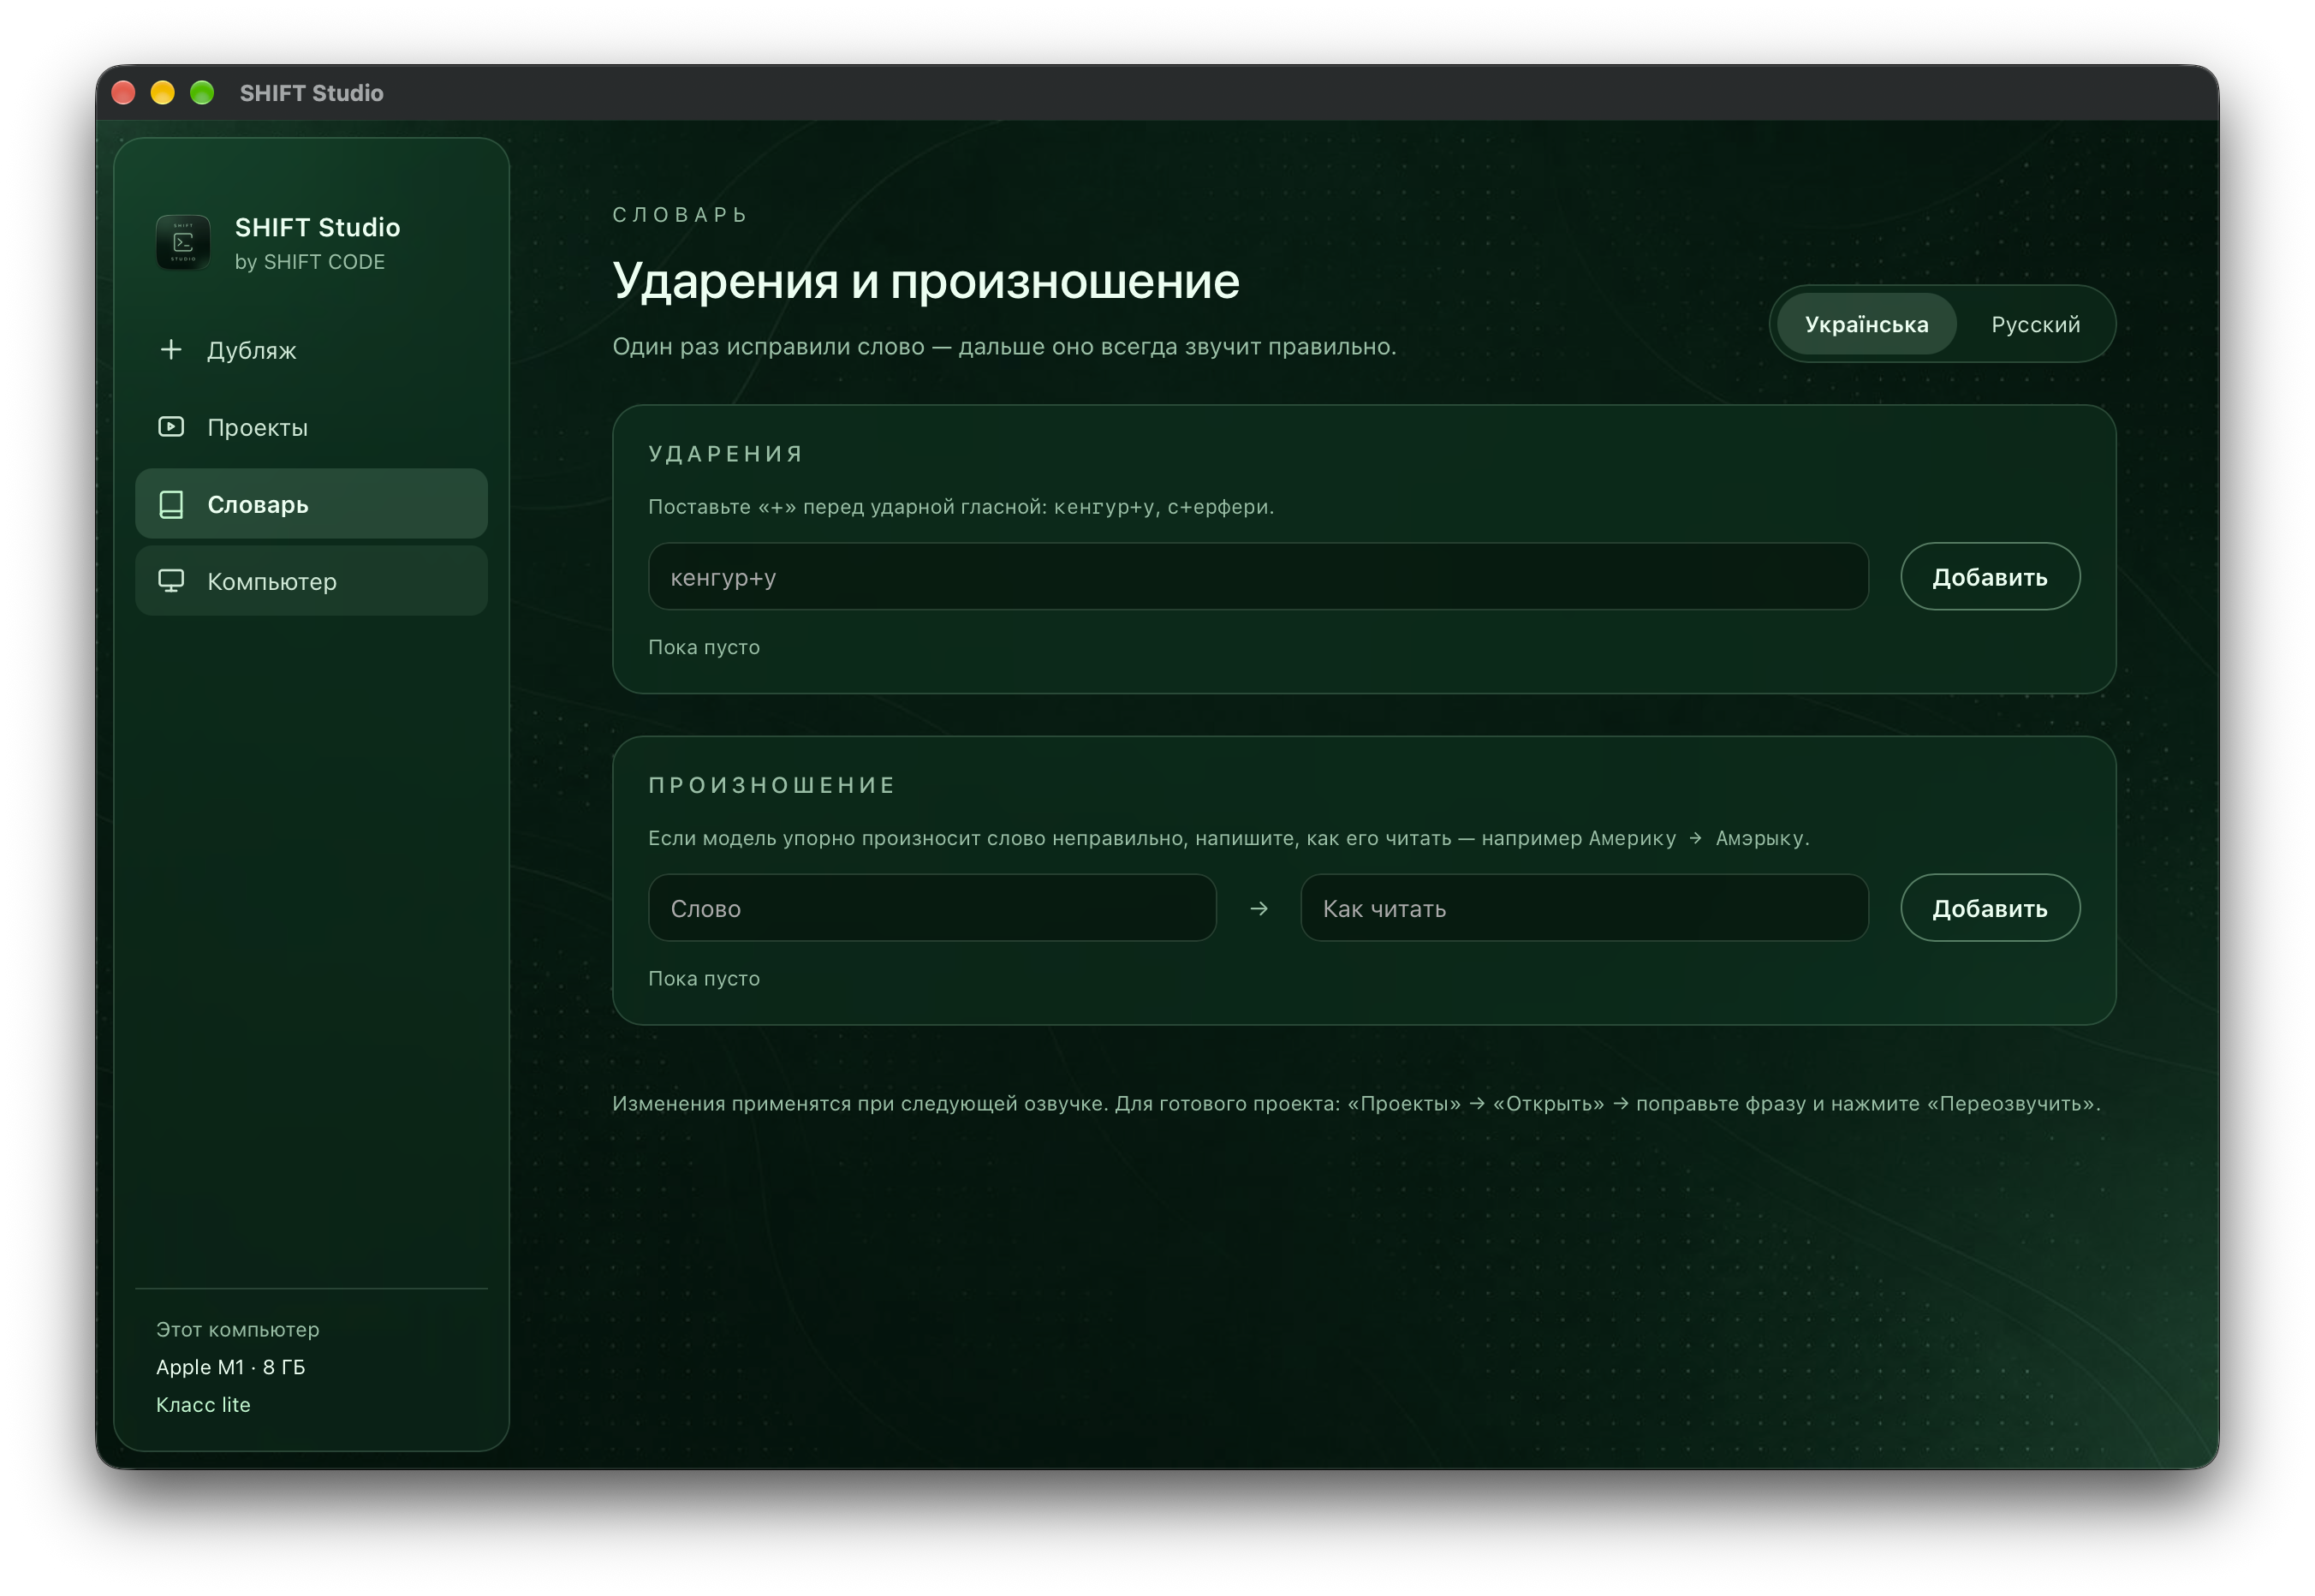
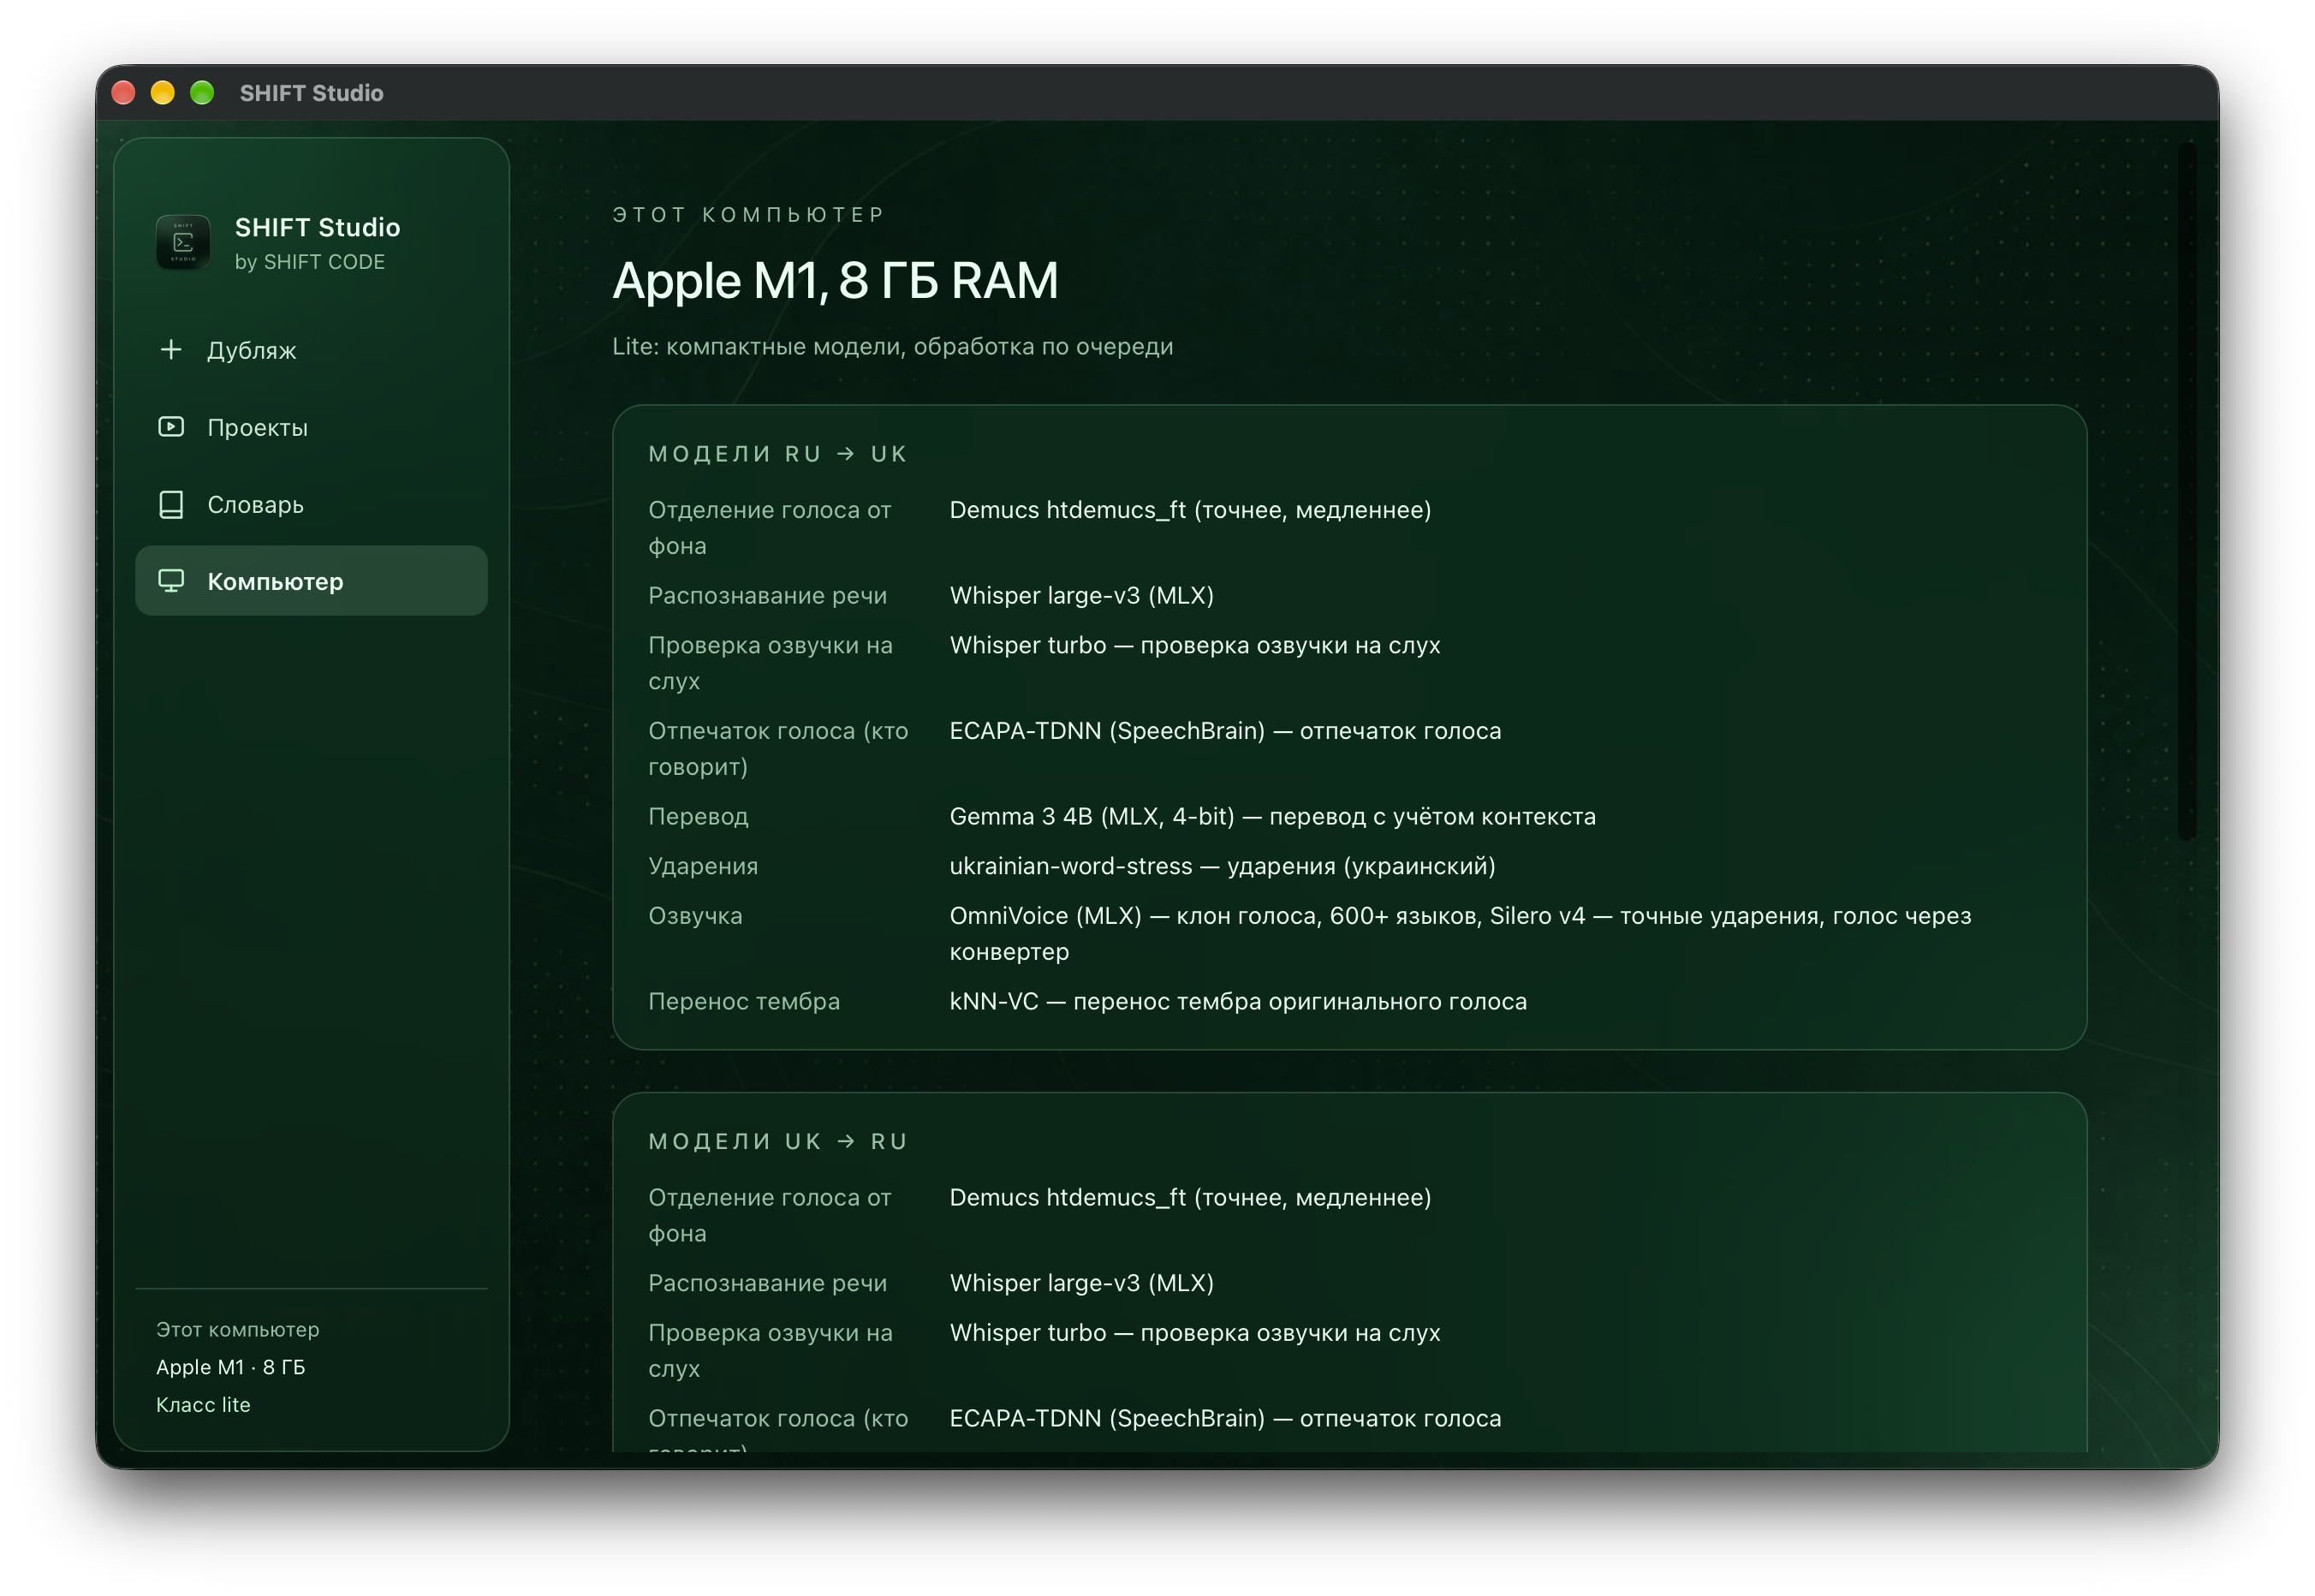
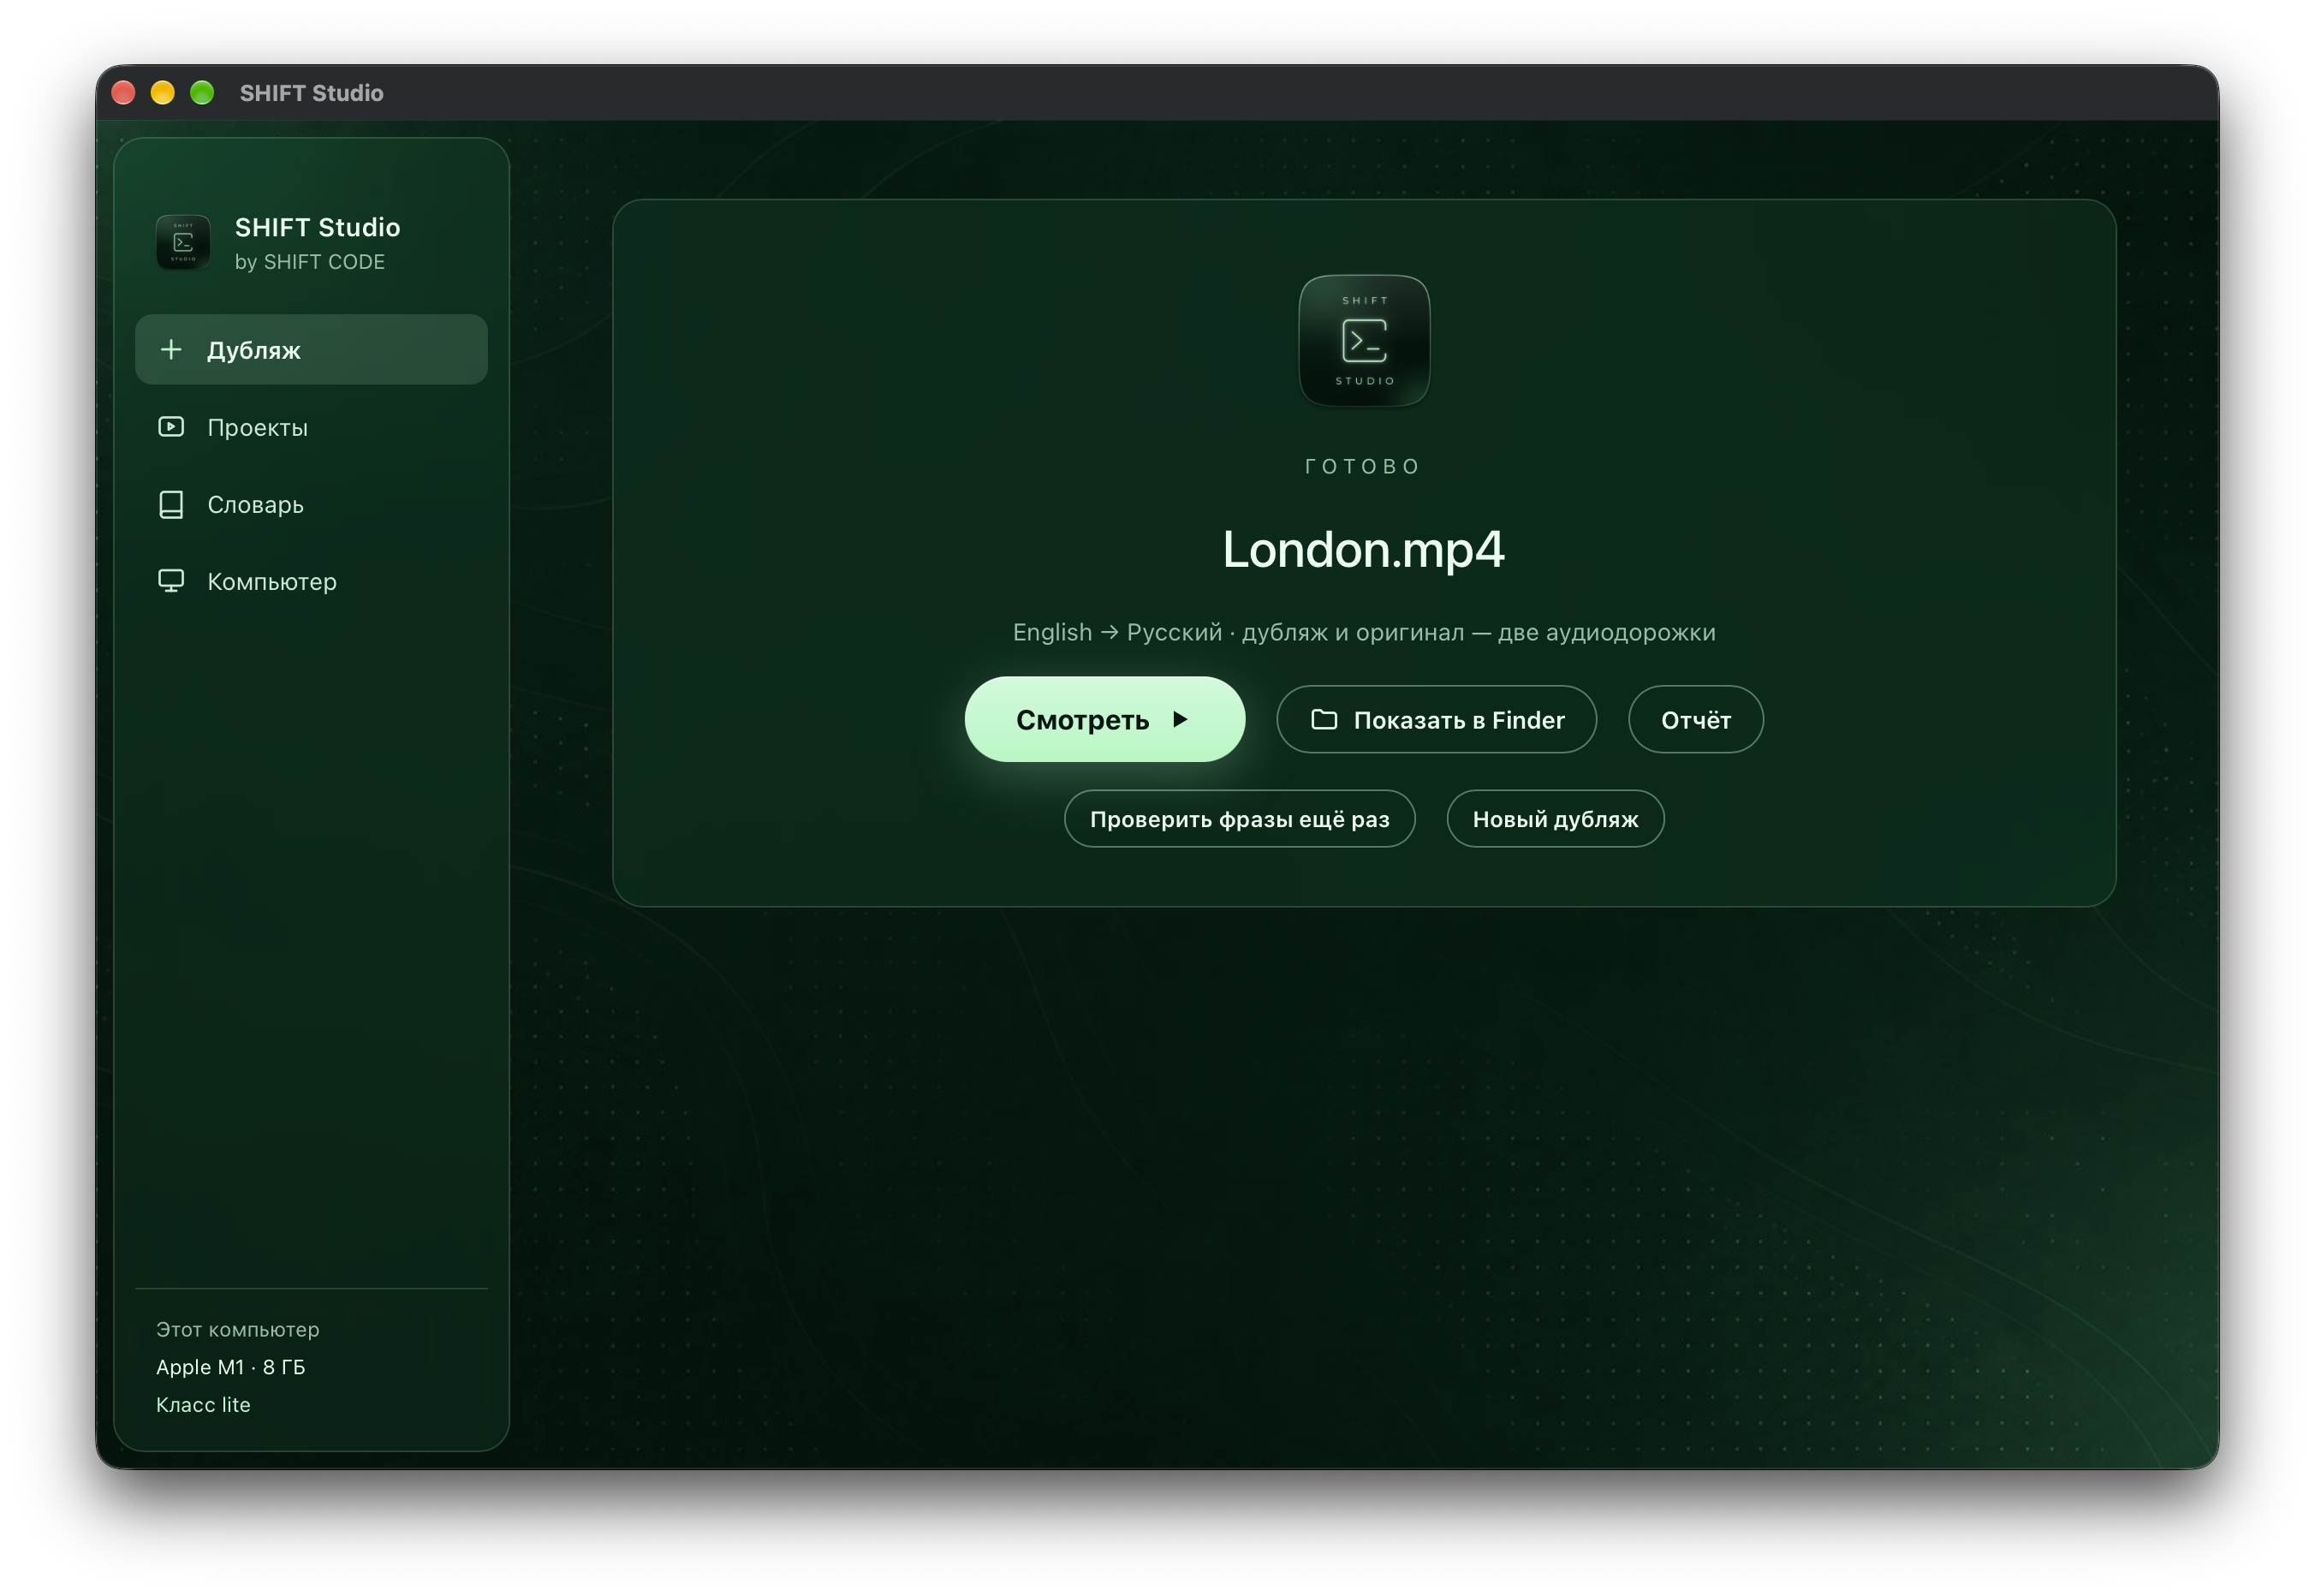
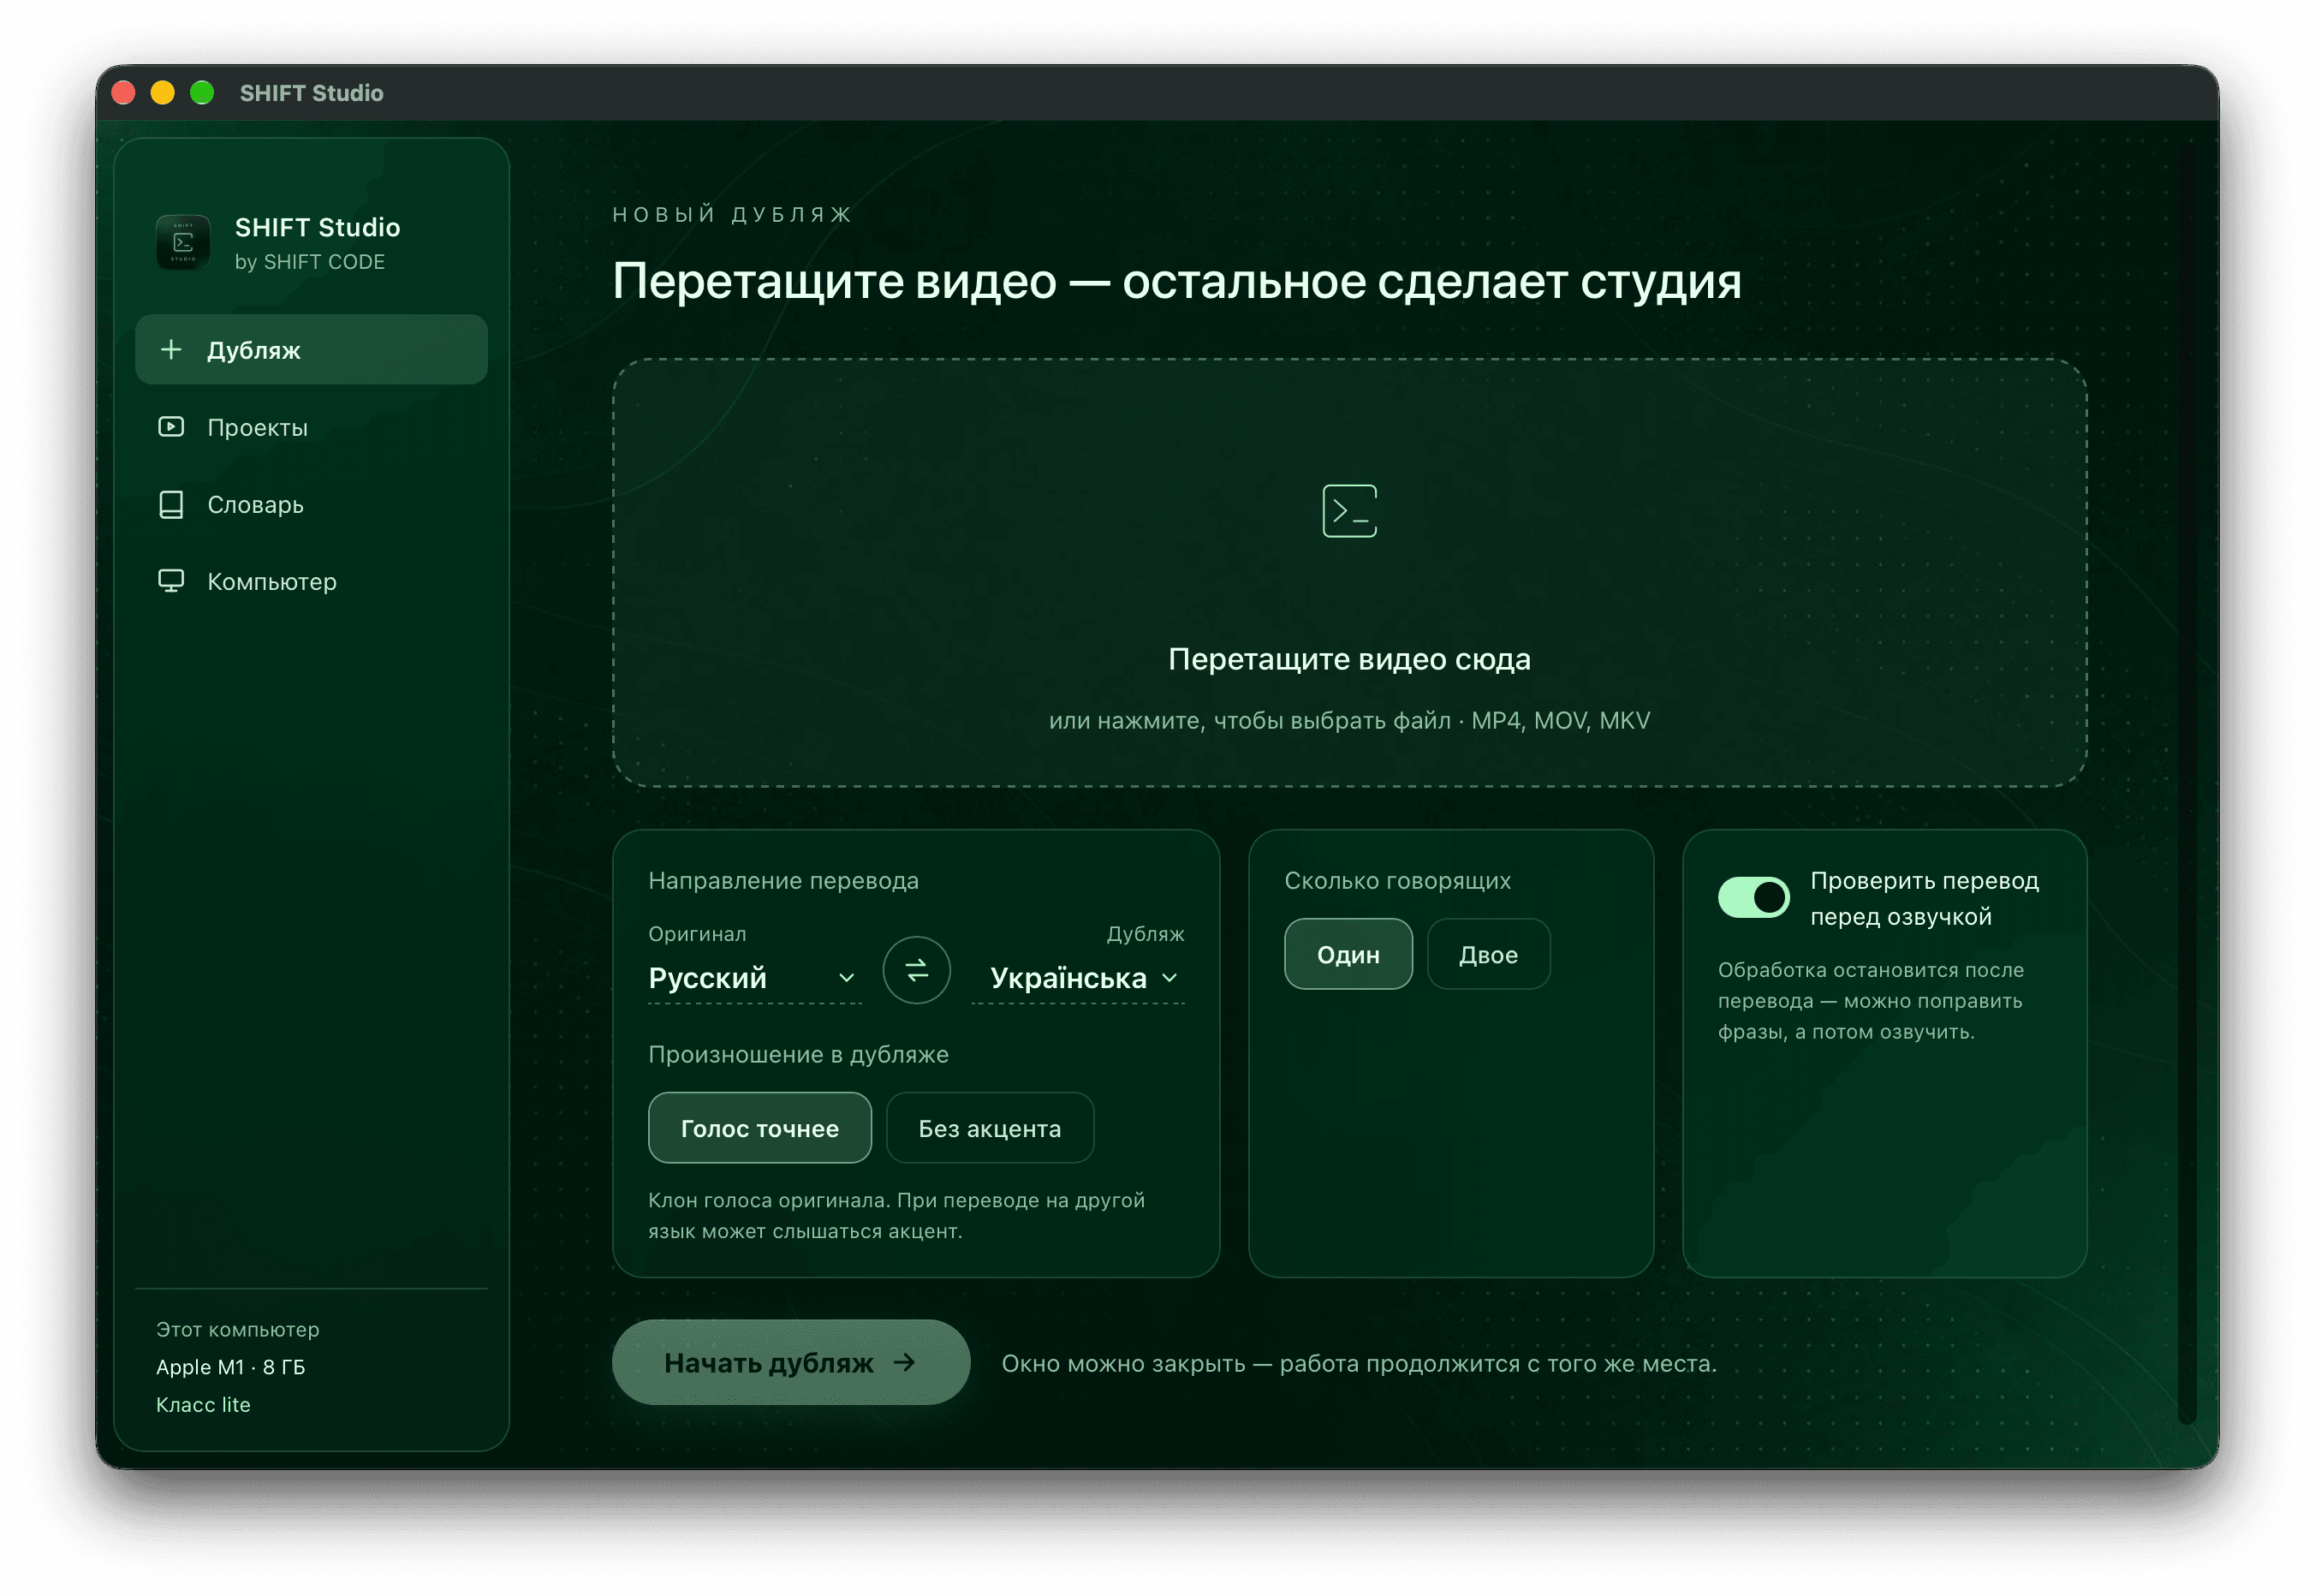
Při instalaci program sám rozpozná procesor, velikost paměti a grafickou kartu, zařadí počítač do jedné z výkonnostních tříd a stáhne modely přesně pro něj: kompaktní na notebooku s 8 GB paměti, ty největší a nejkvalitnější na výkonném stroji. Uživatel vybere jen jazyky a počet mluvčích a získá video s překladem nadabovaným hlasem původního mluvčího přesně podle časových kódů, se zachovanou hudbou a pozadím, titulky a původní zvukovou stopou. Pro ty, kterým záleží na čisté výslovnosti, je k dispozici režim bez přízvuku: mluví rodilý hlas a barva původního hlasu se přenáší samostatným modelem.
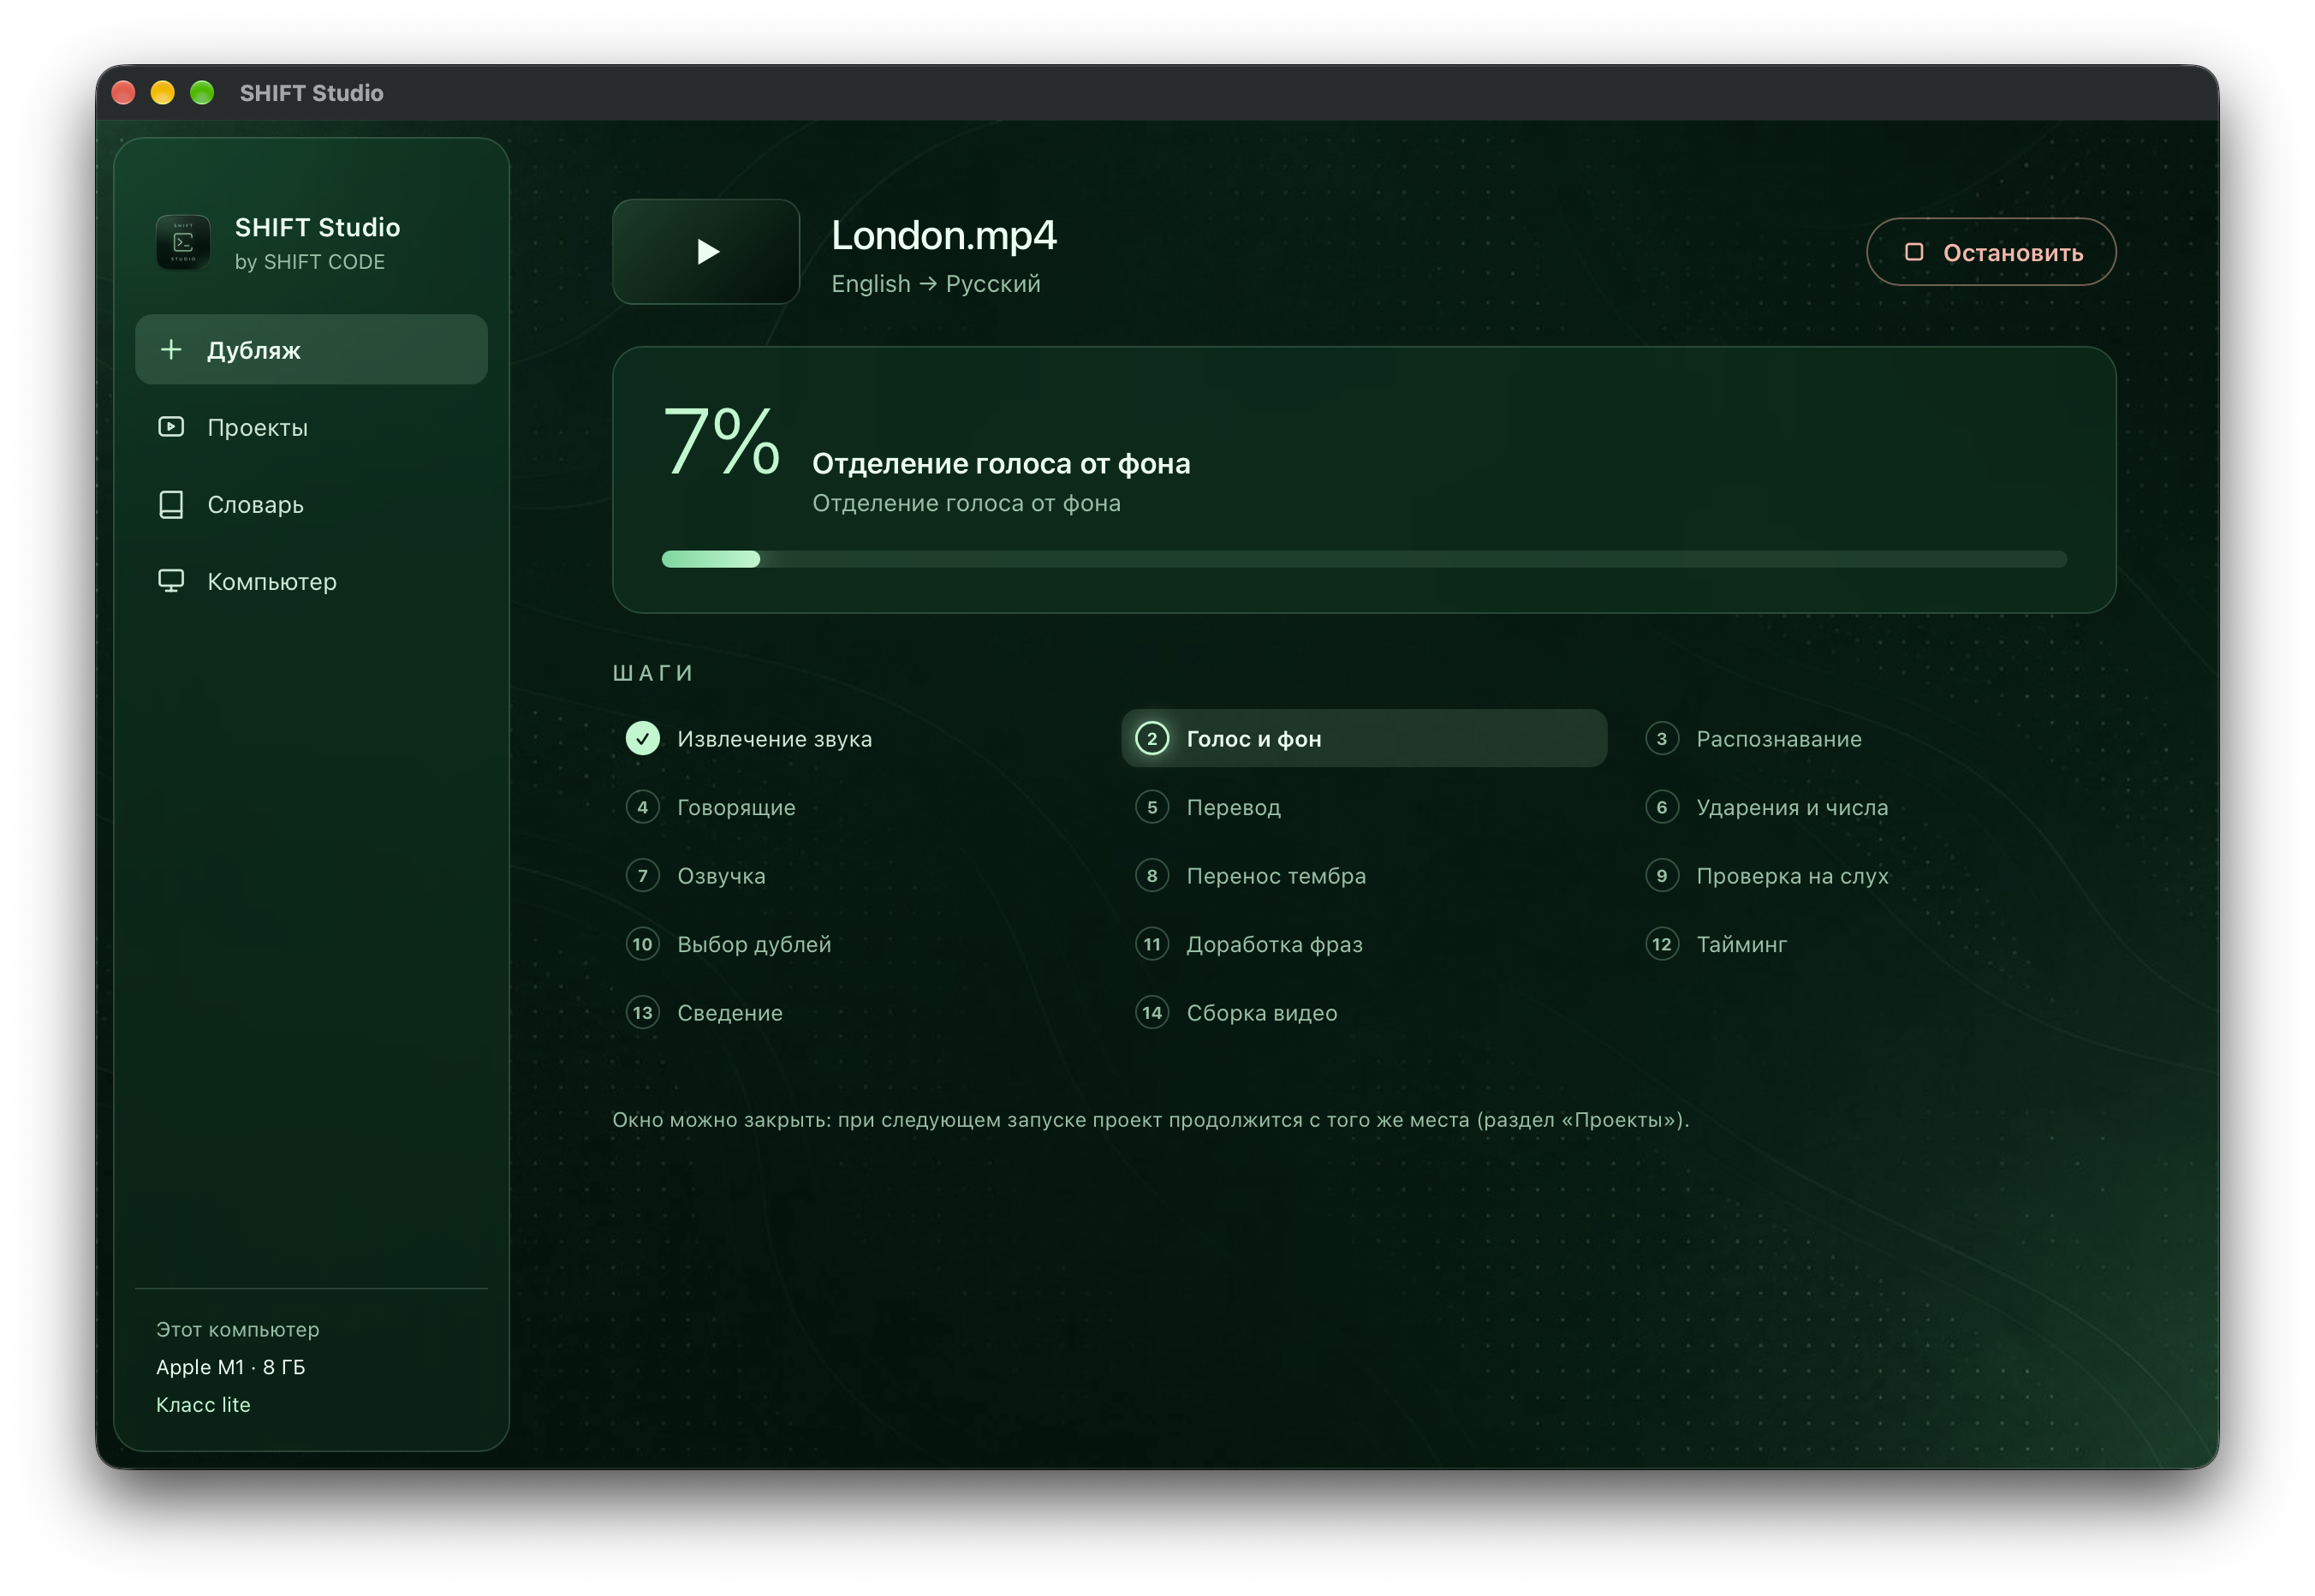
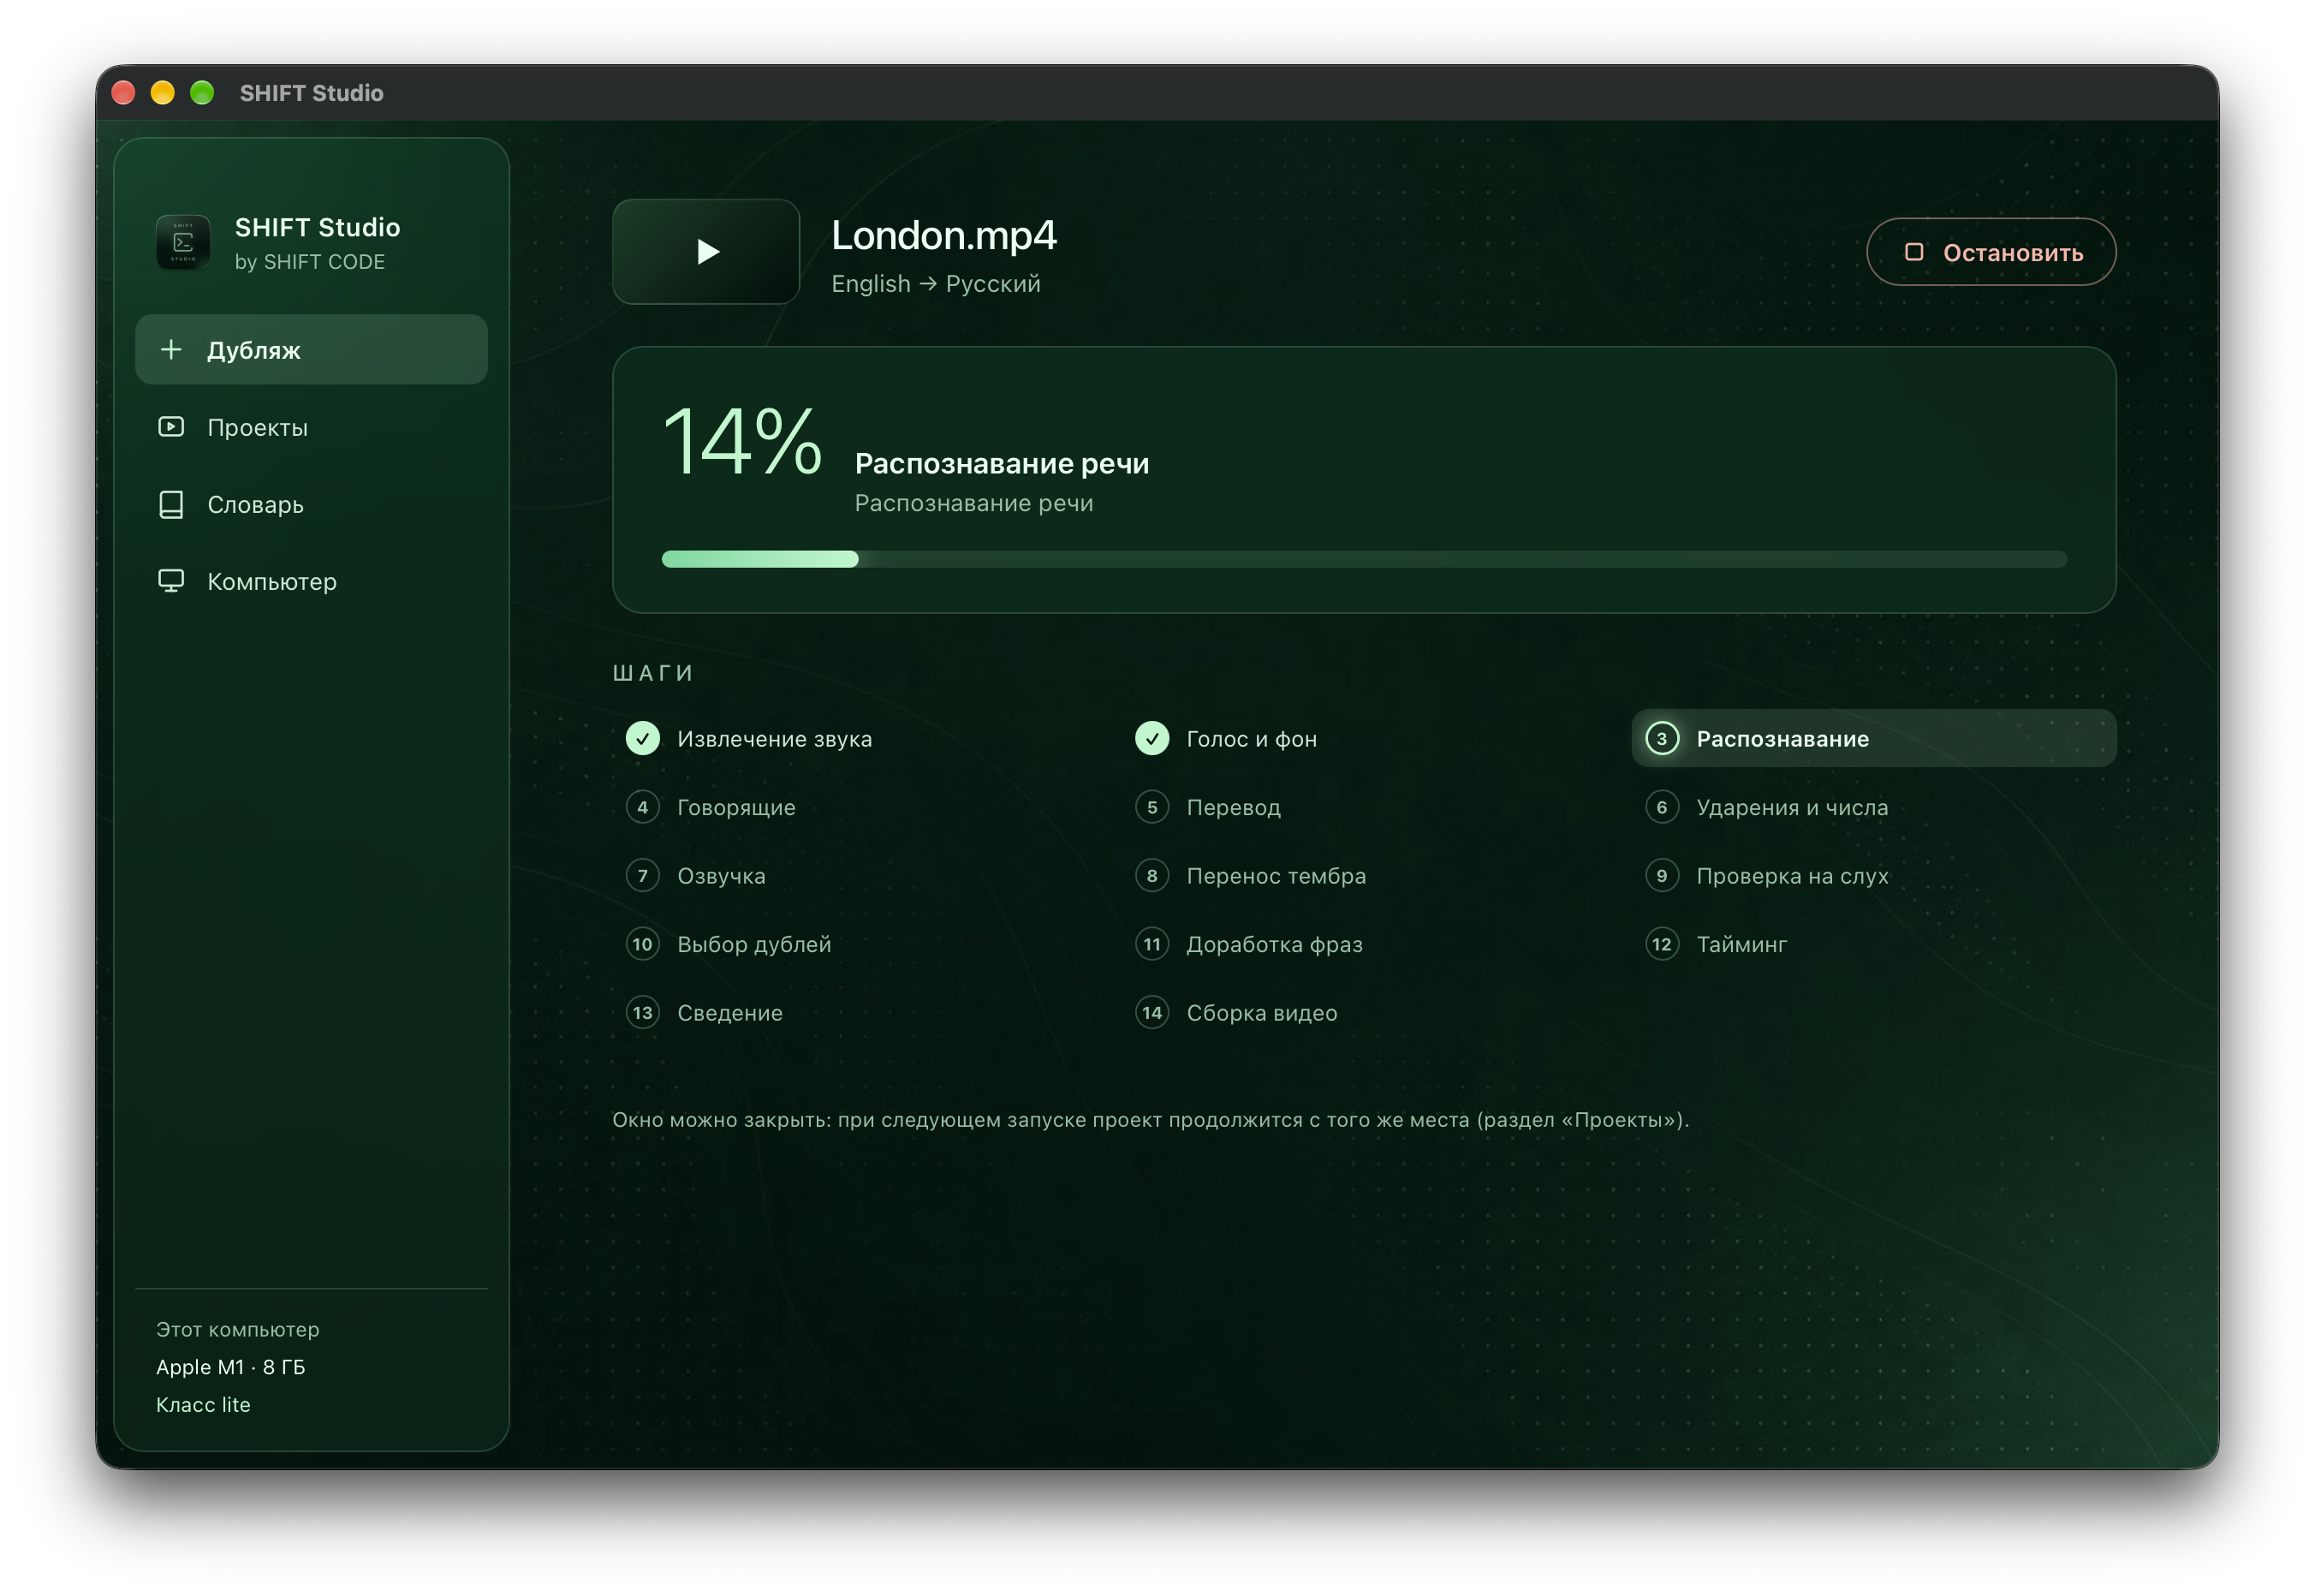
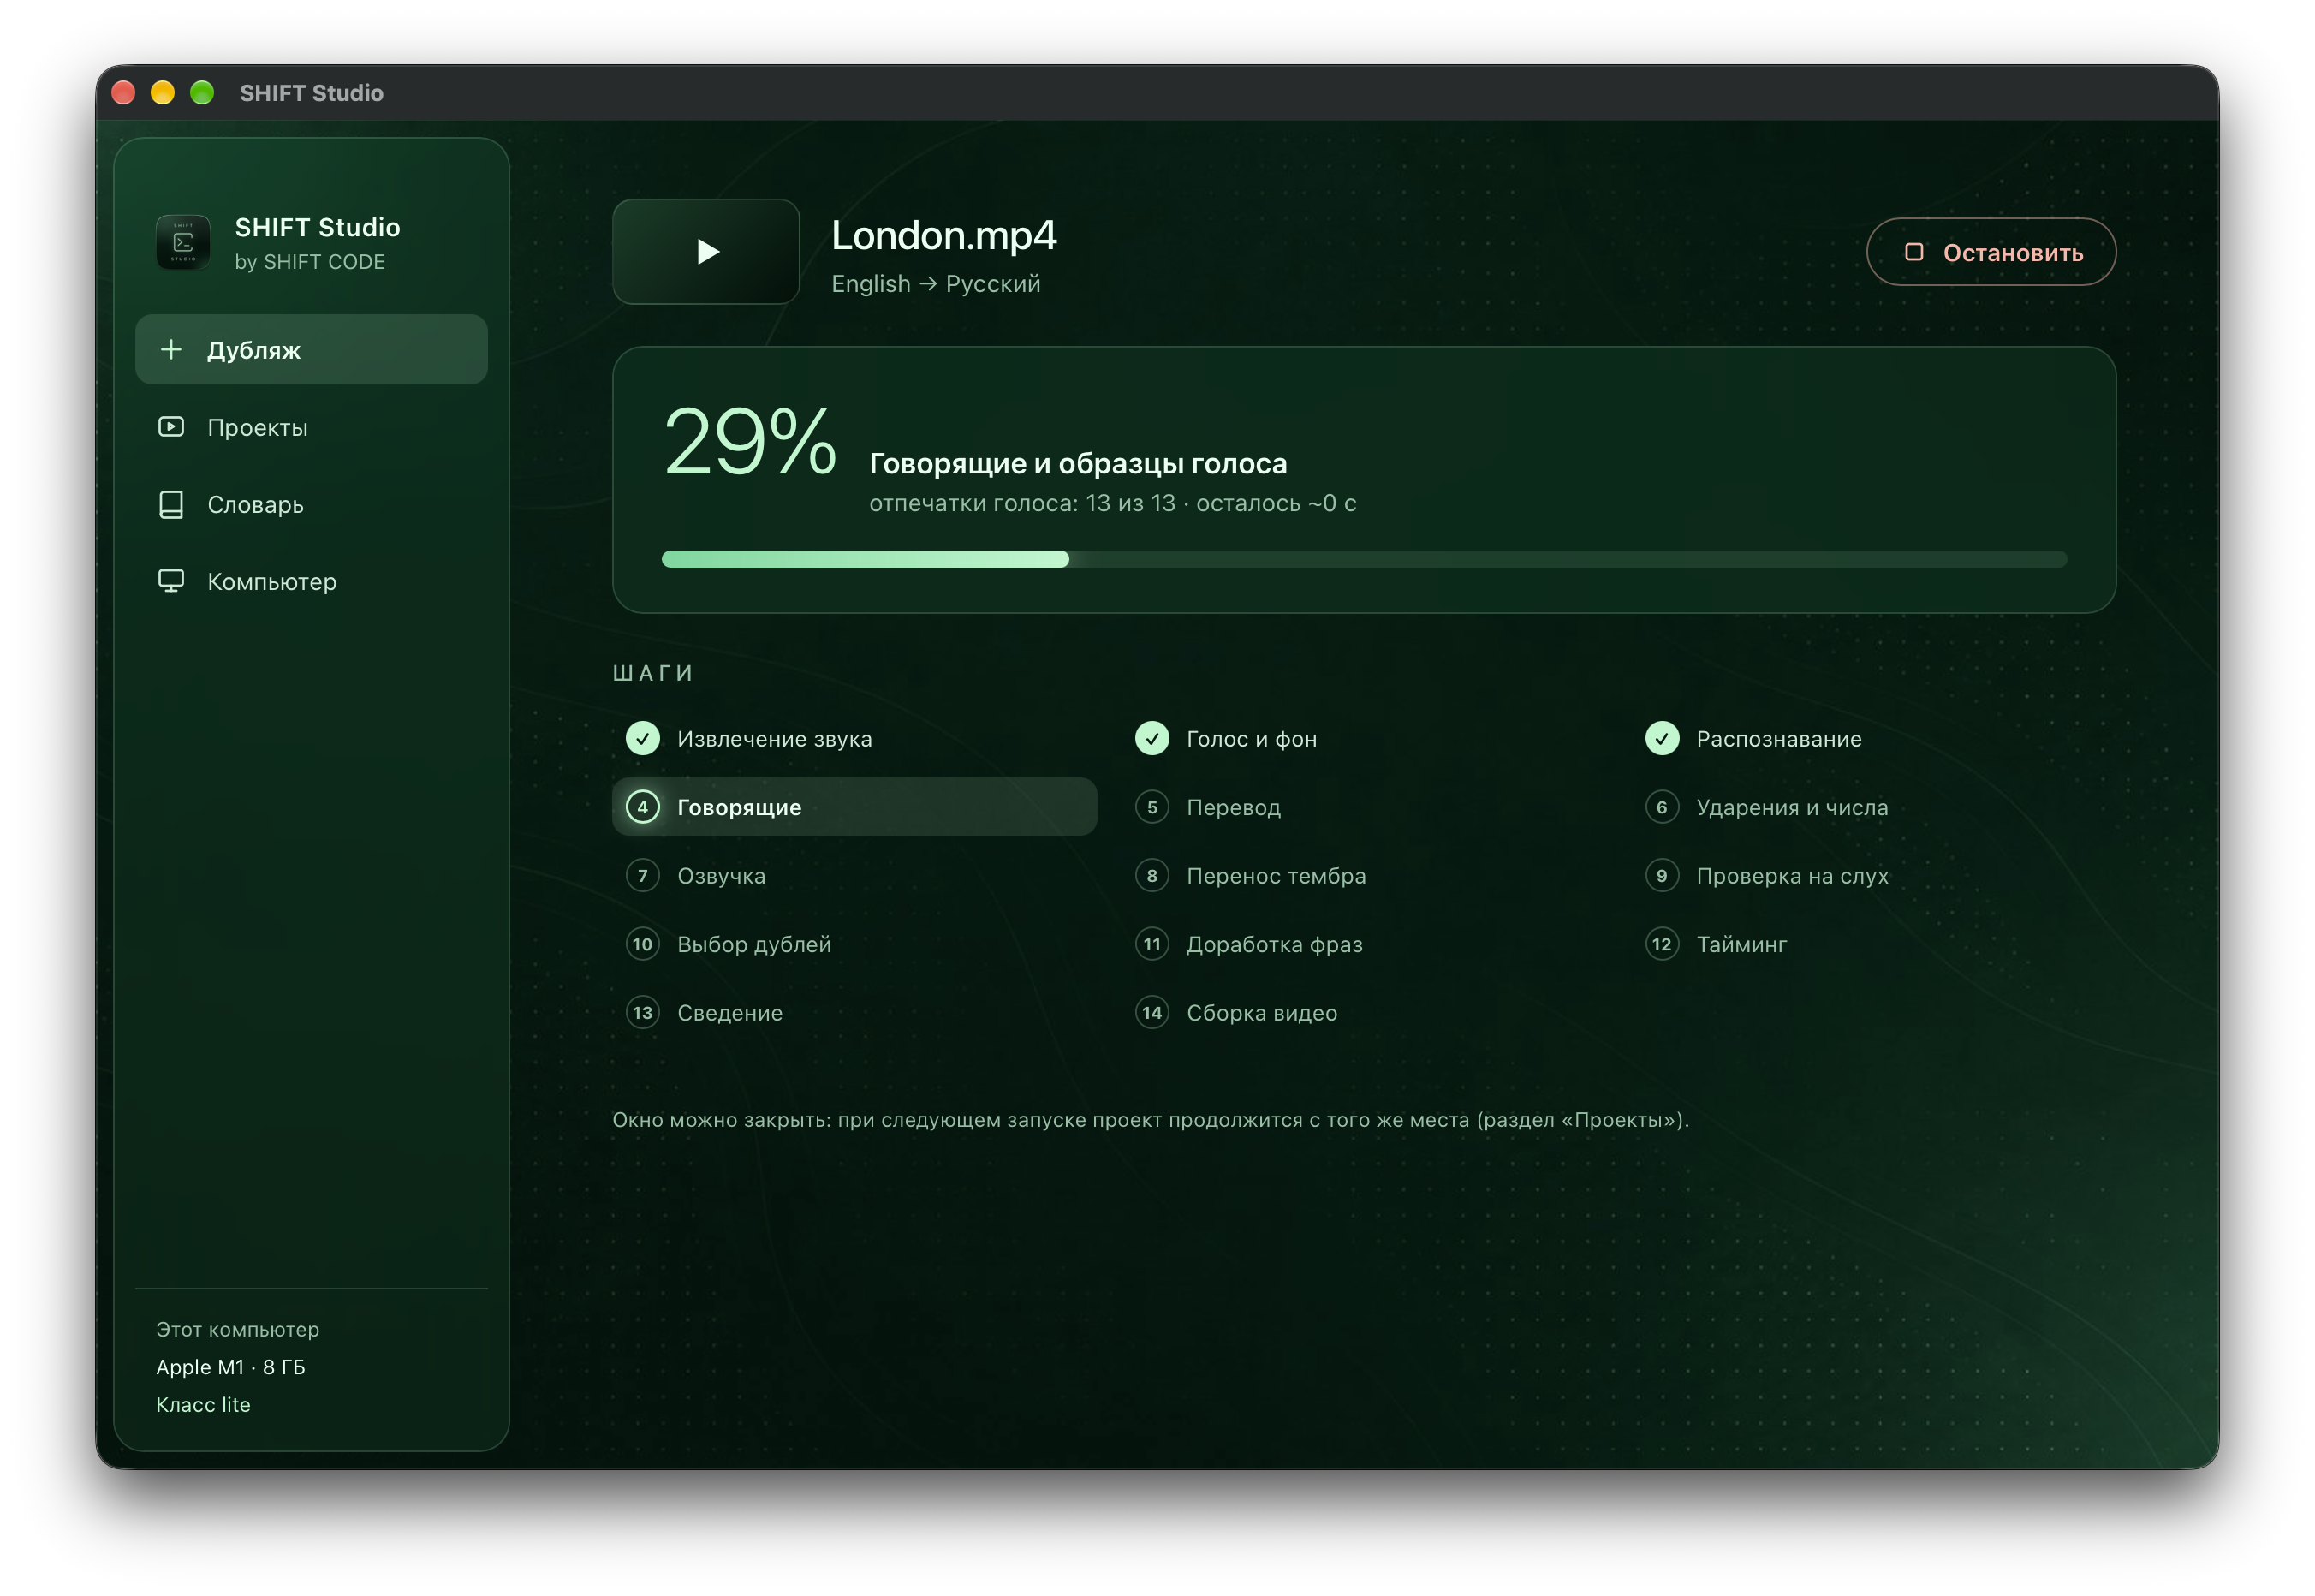
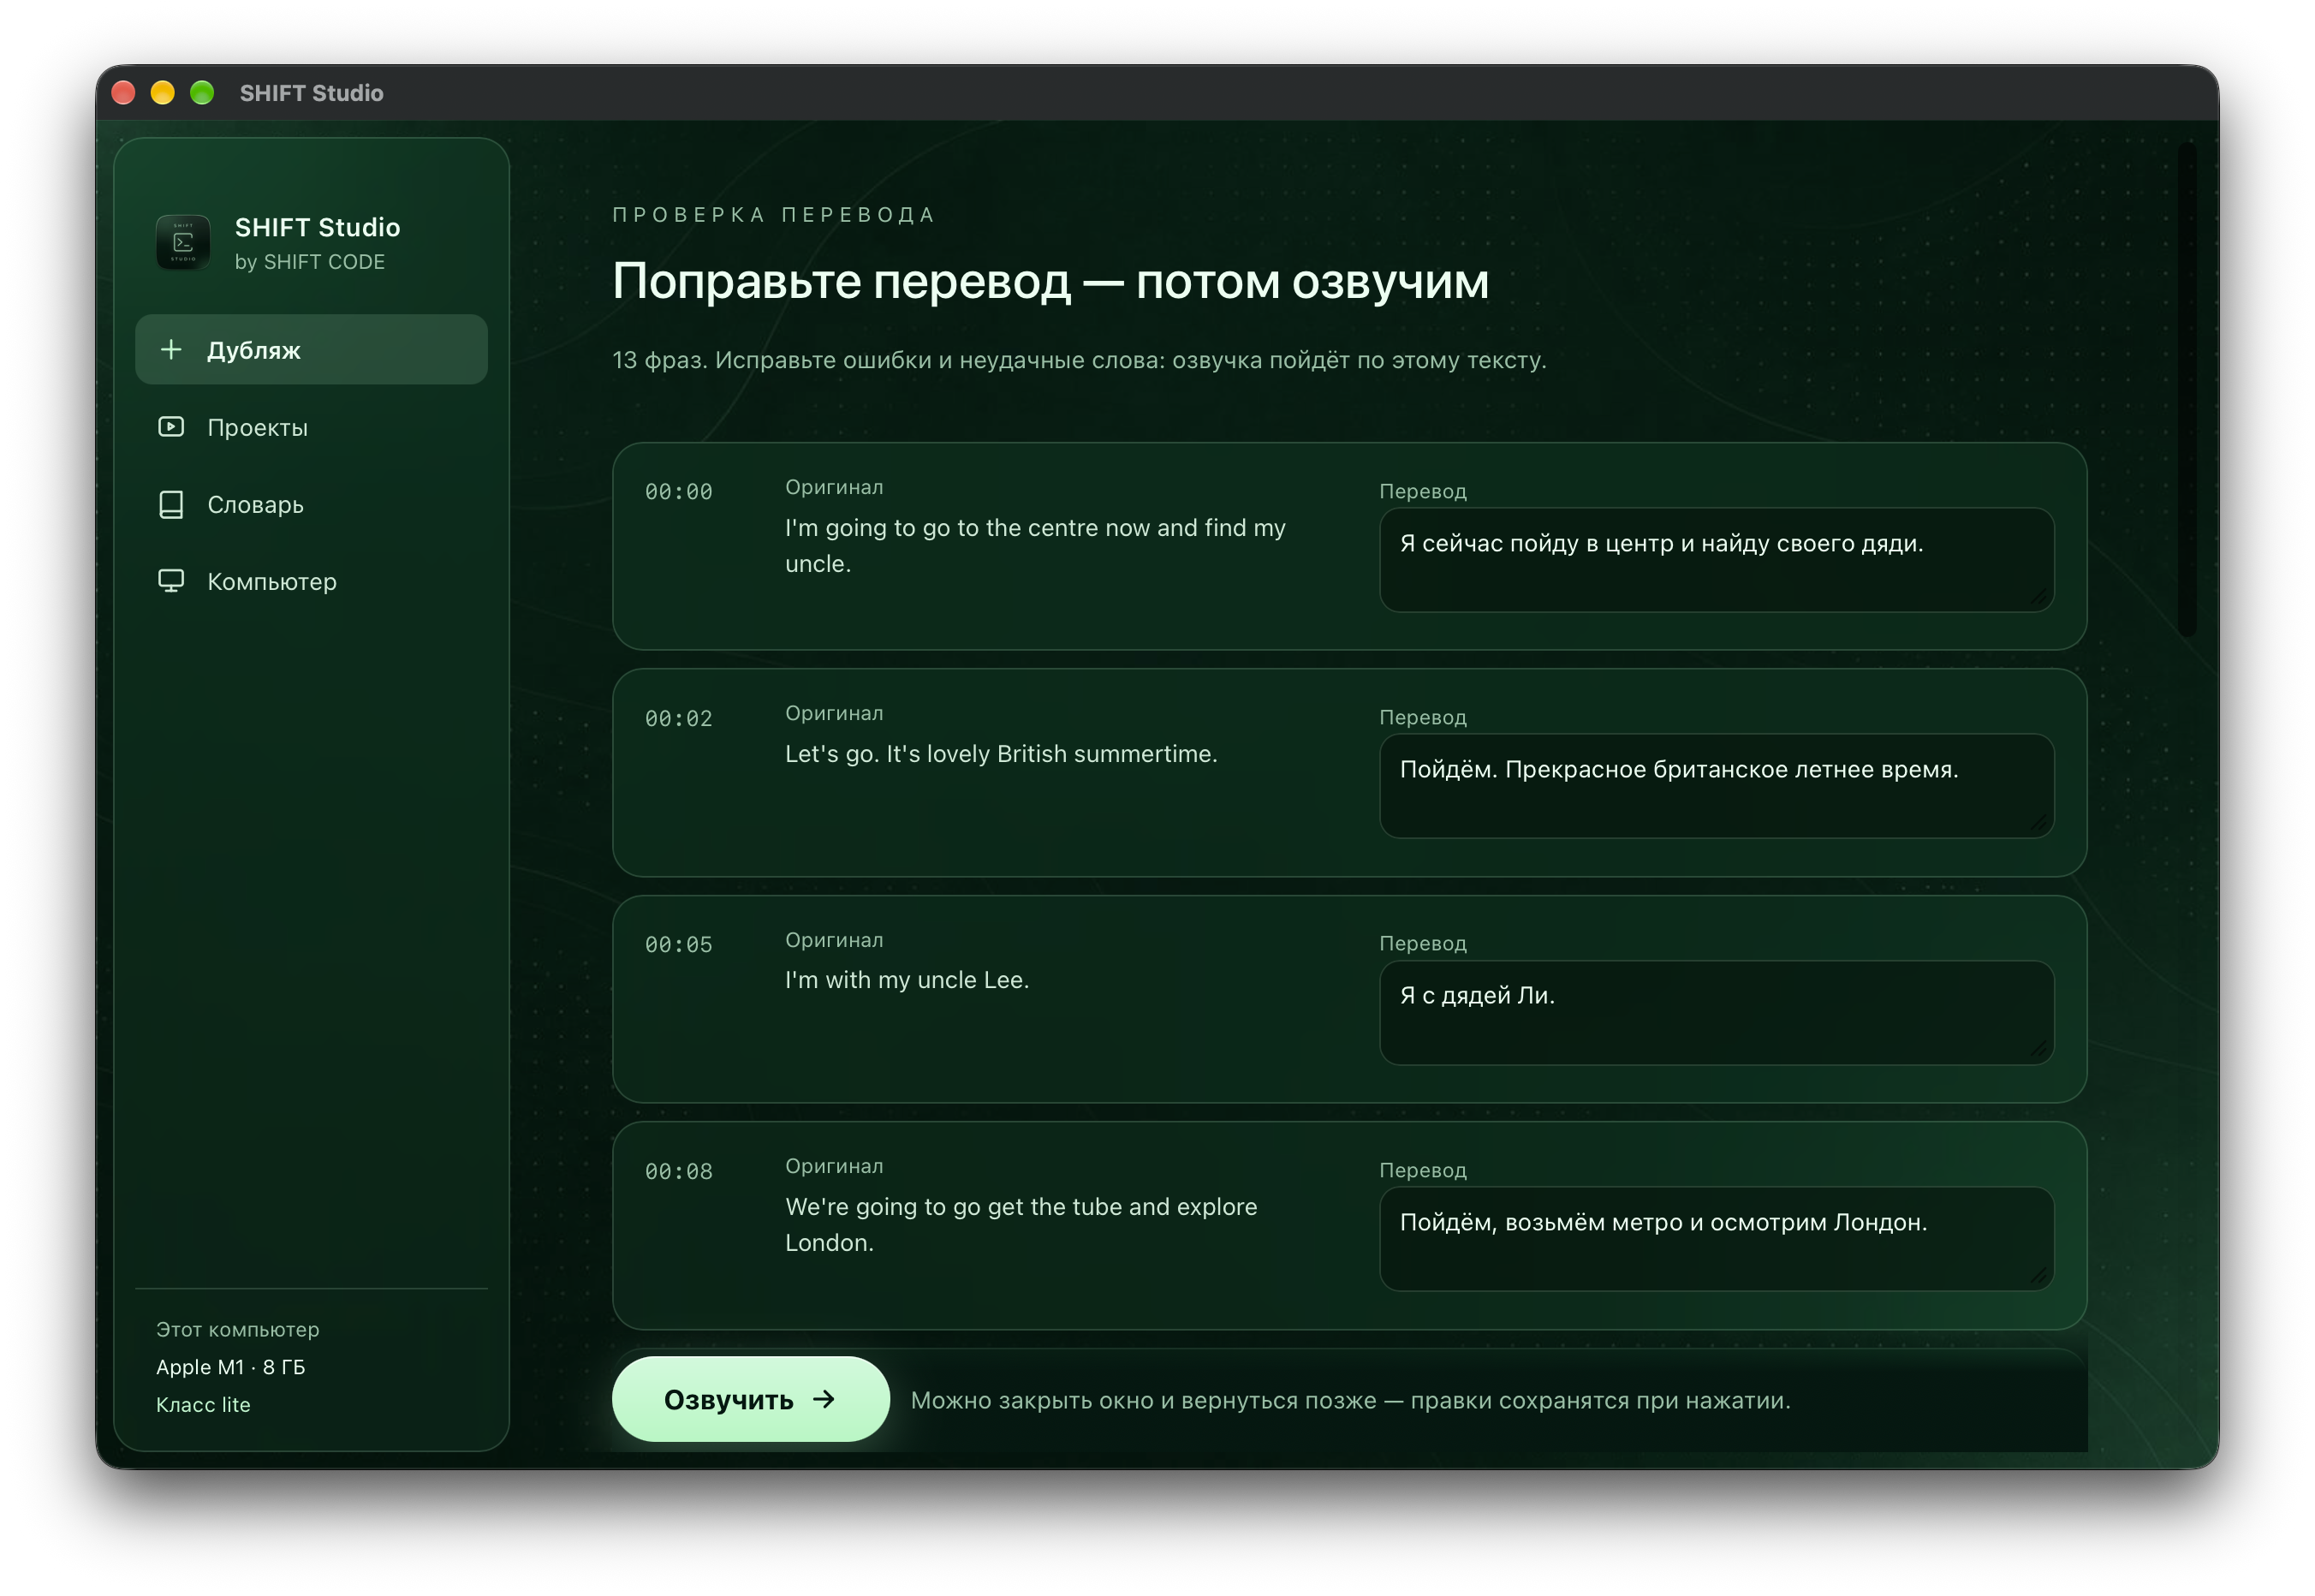
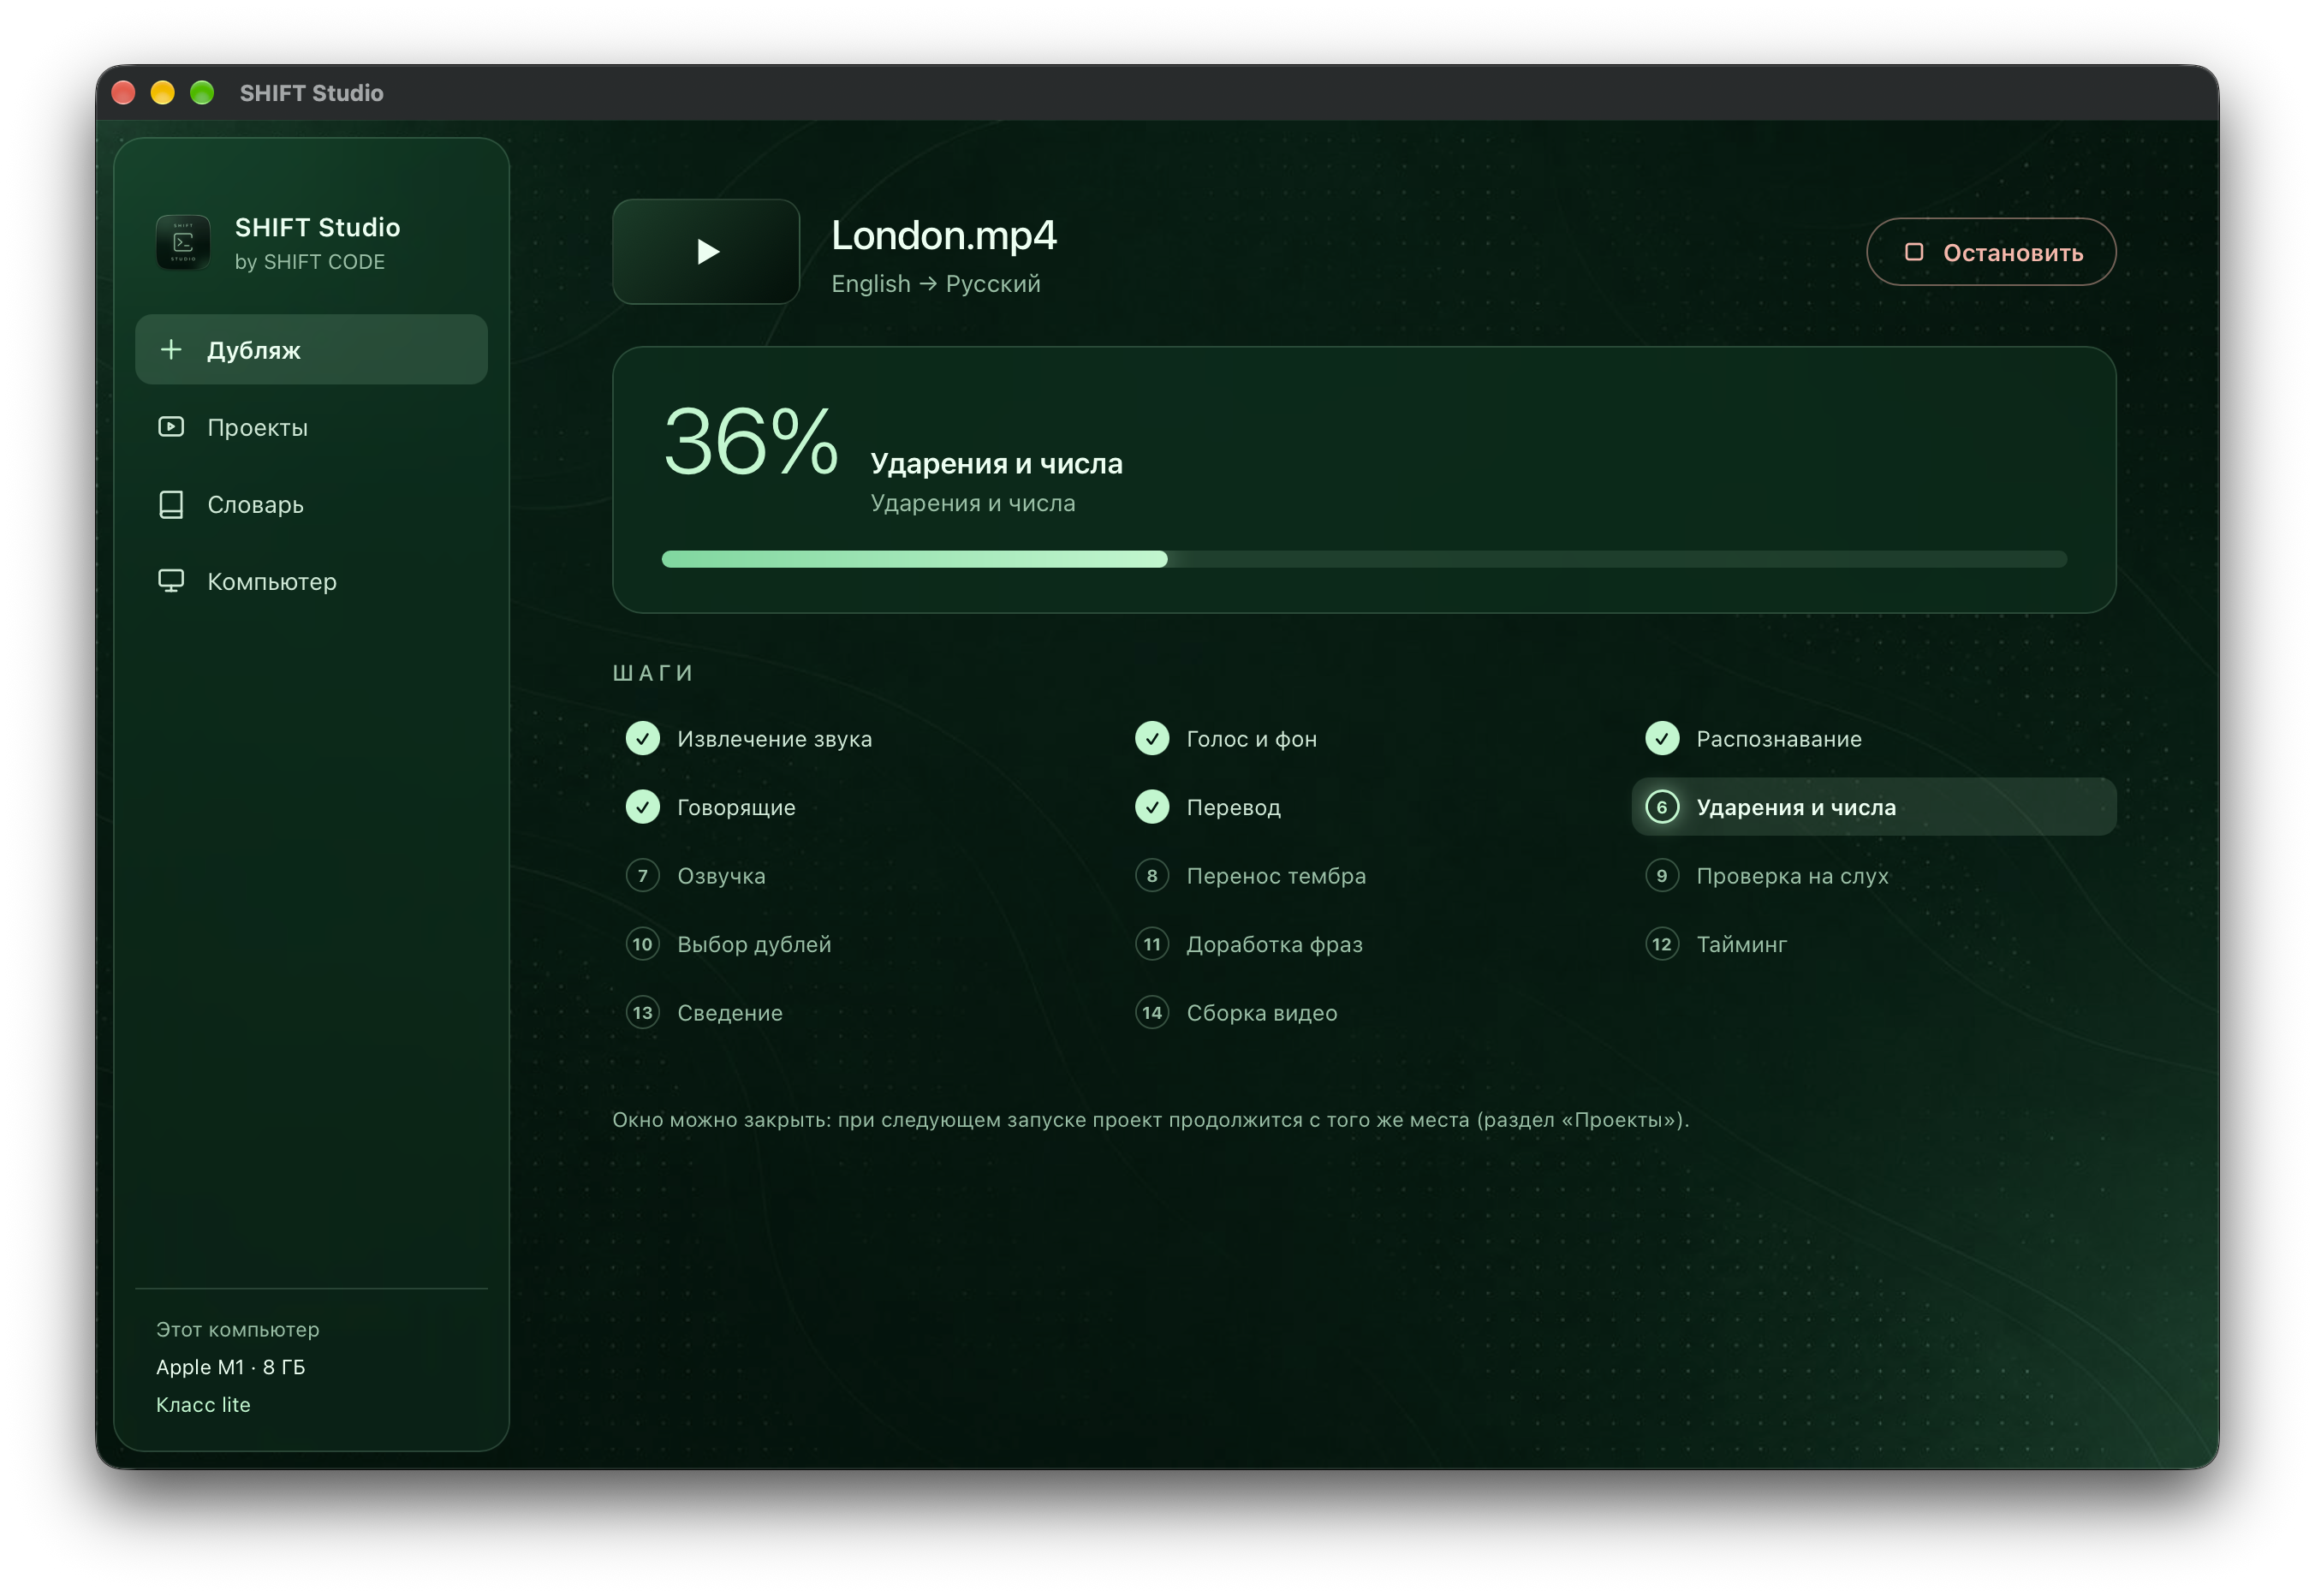
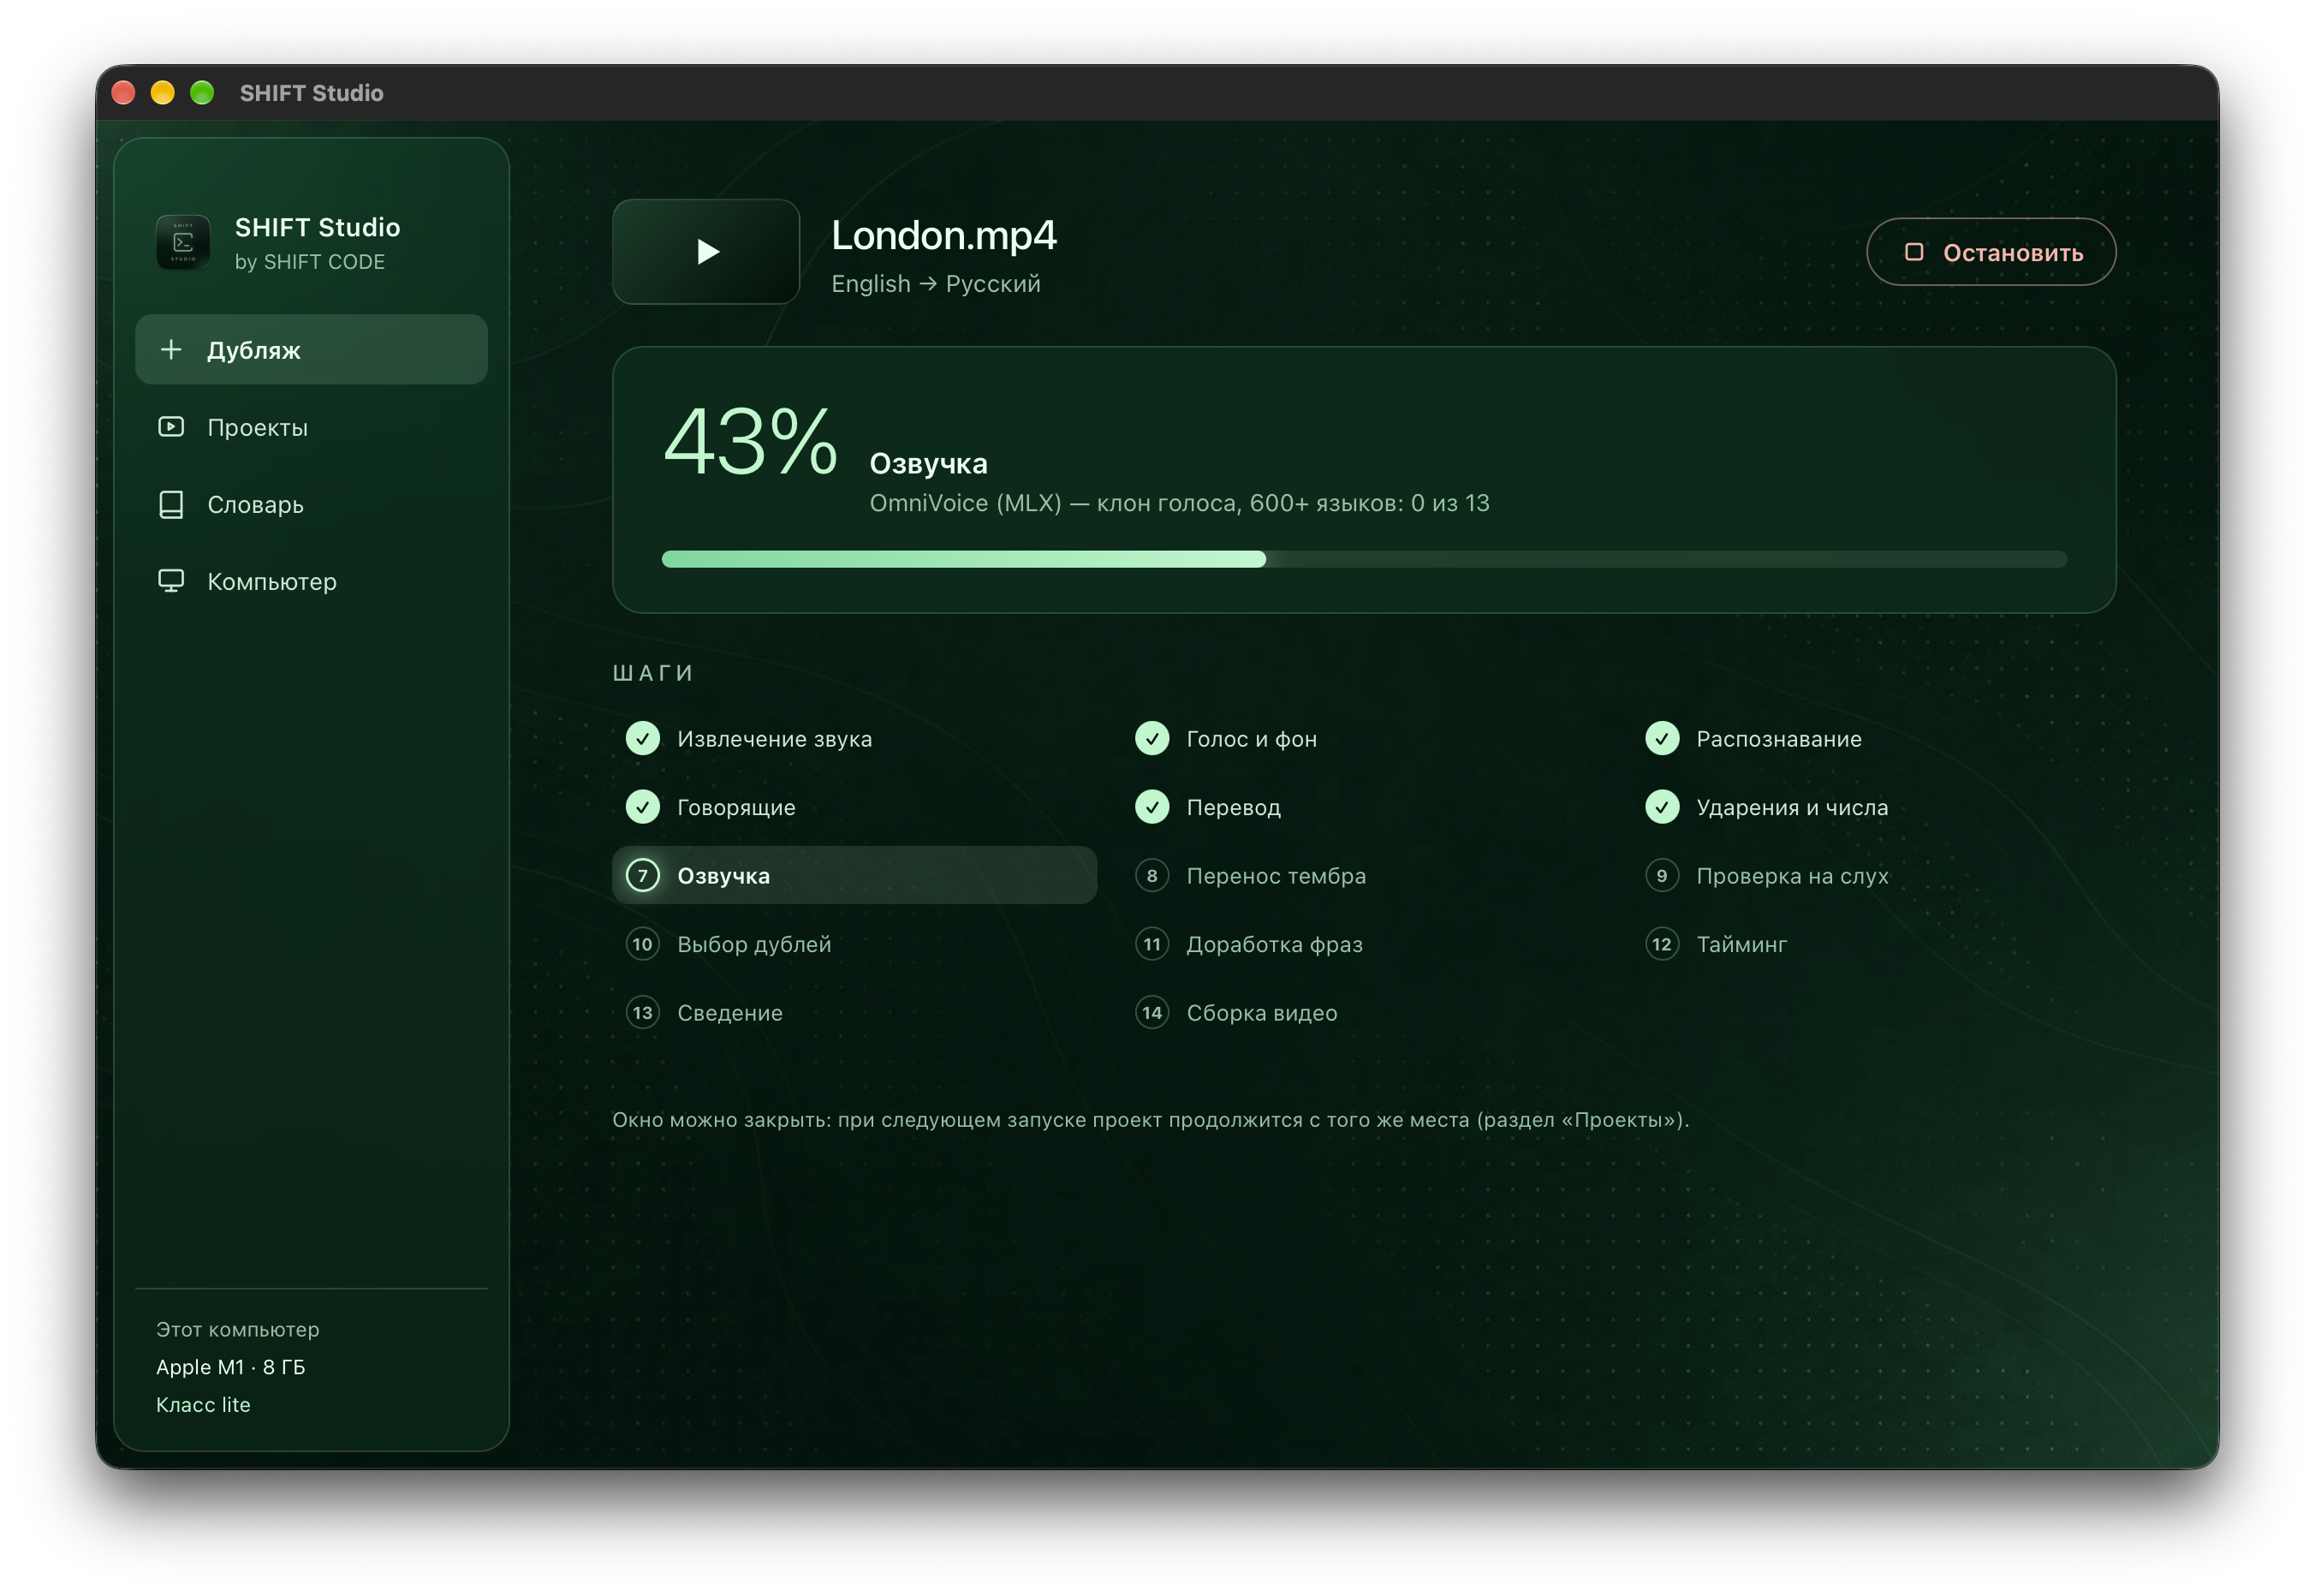
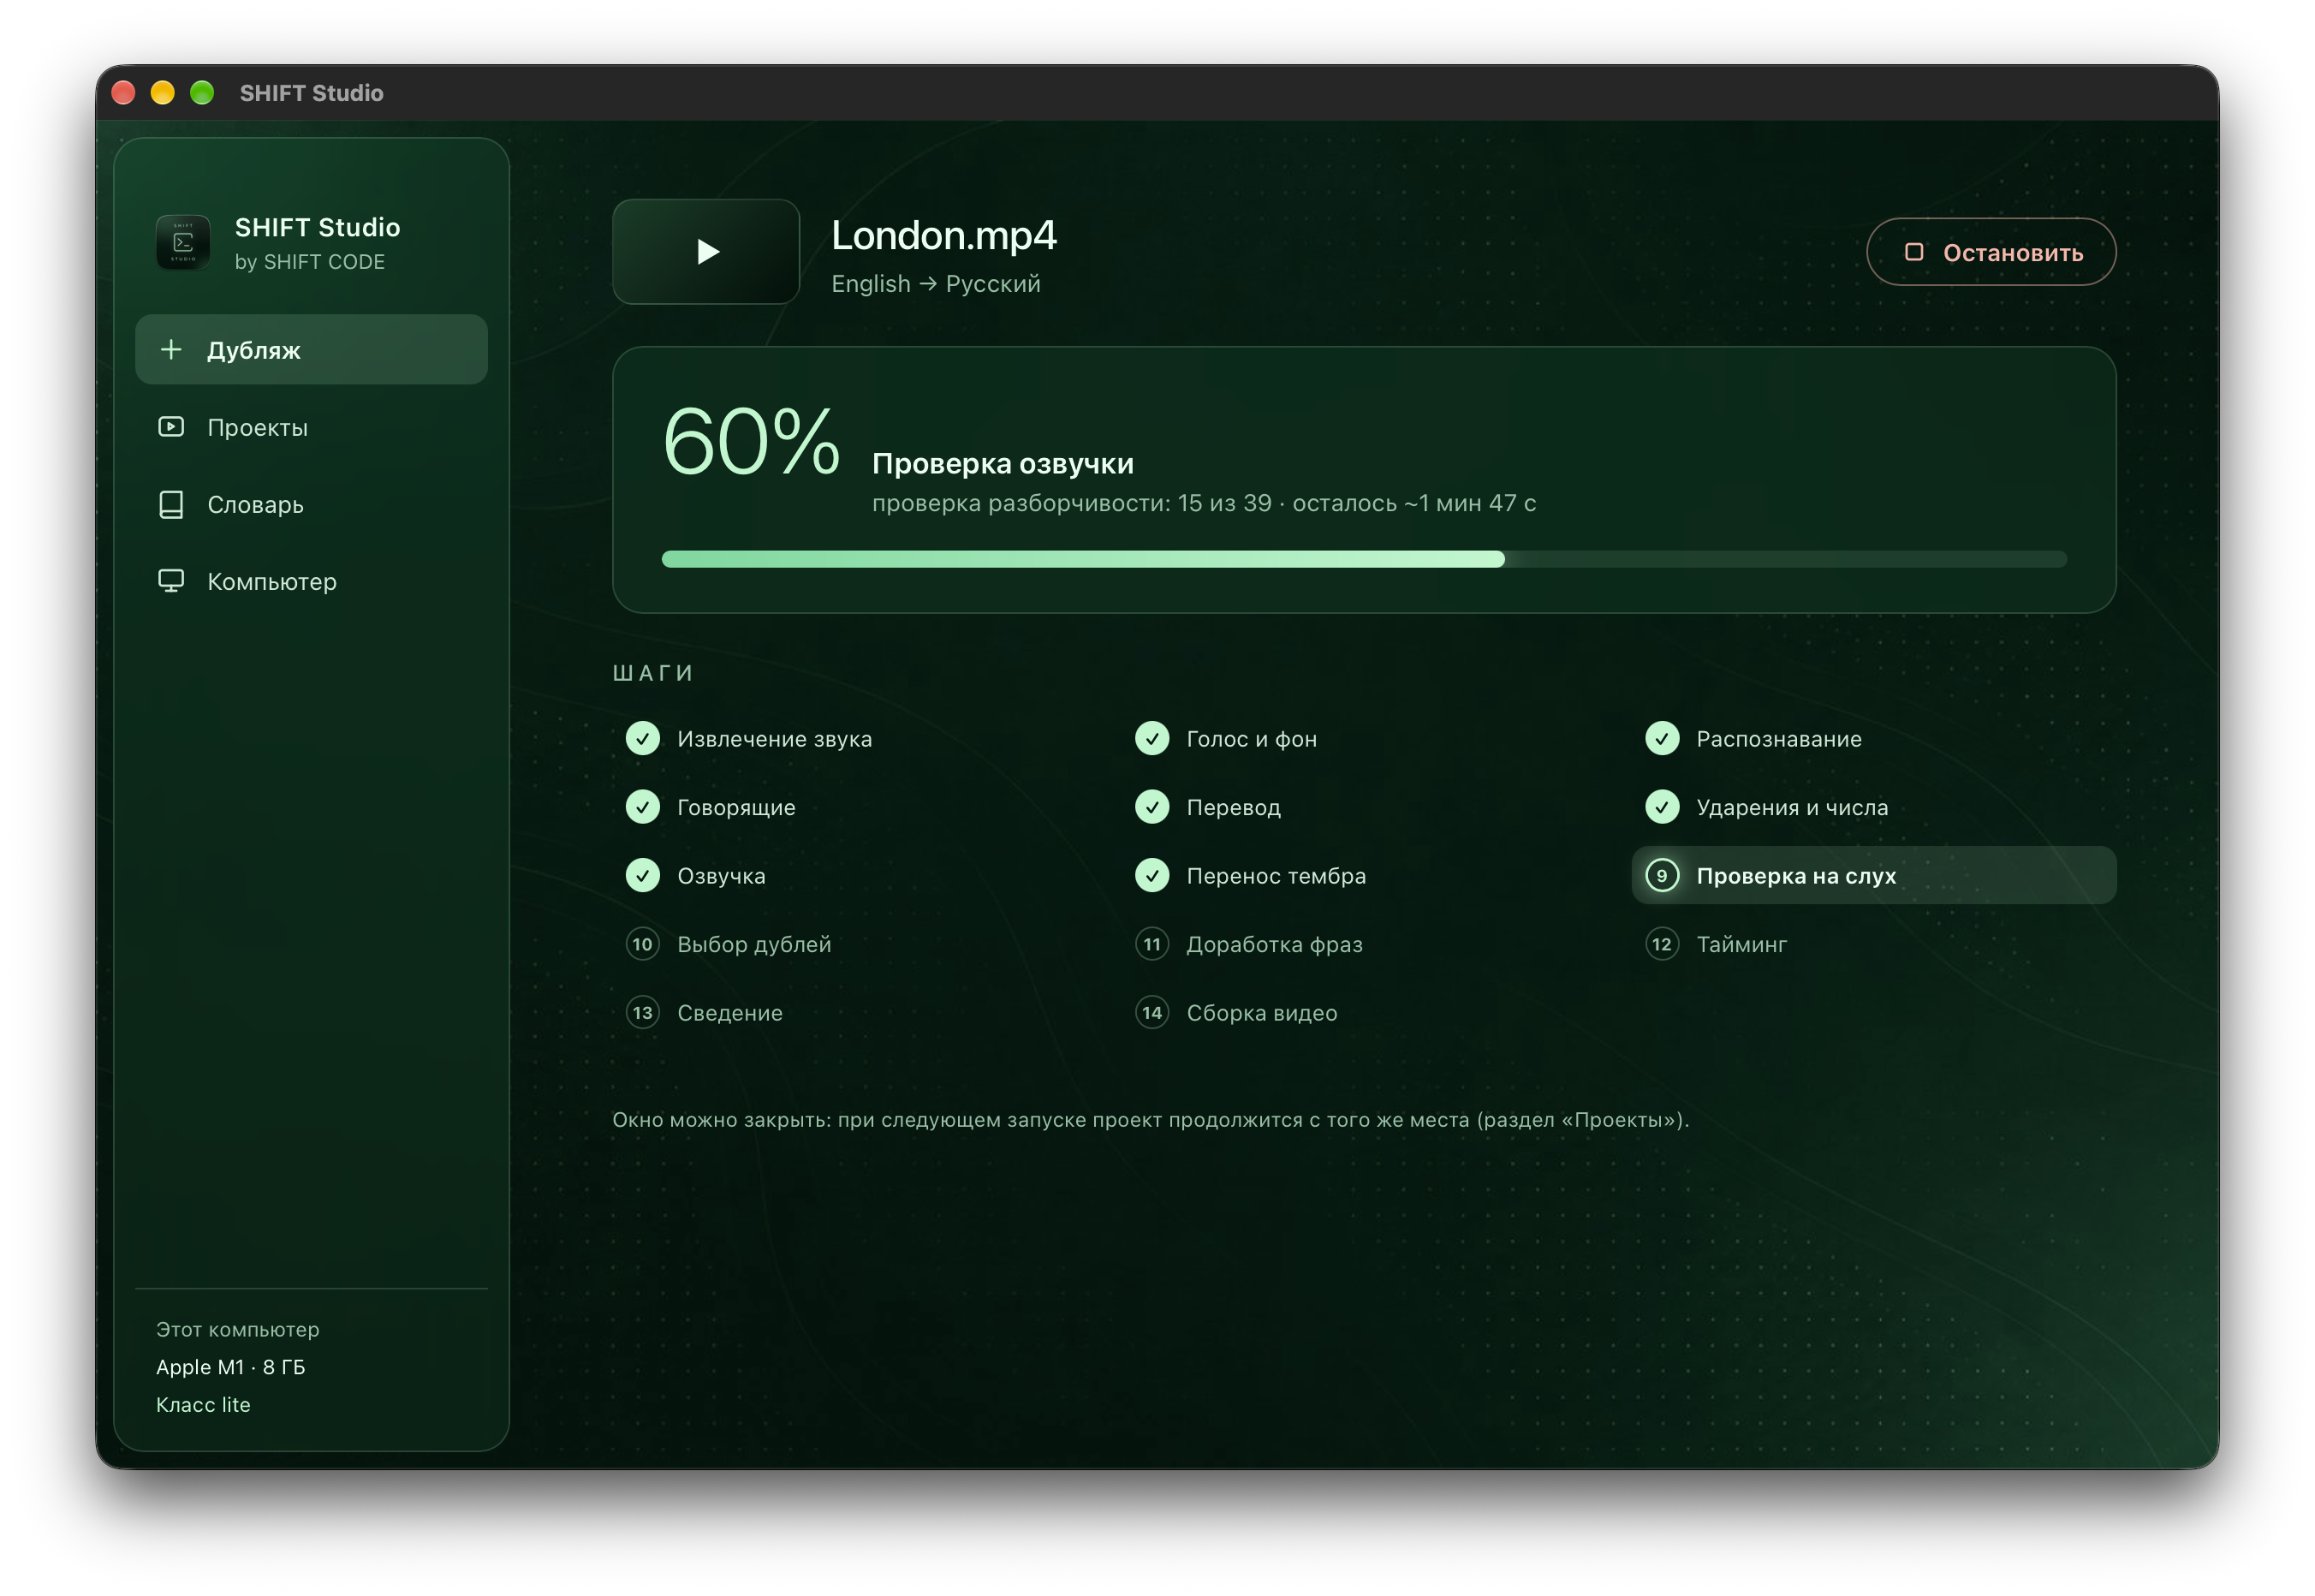
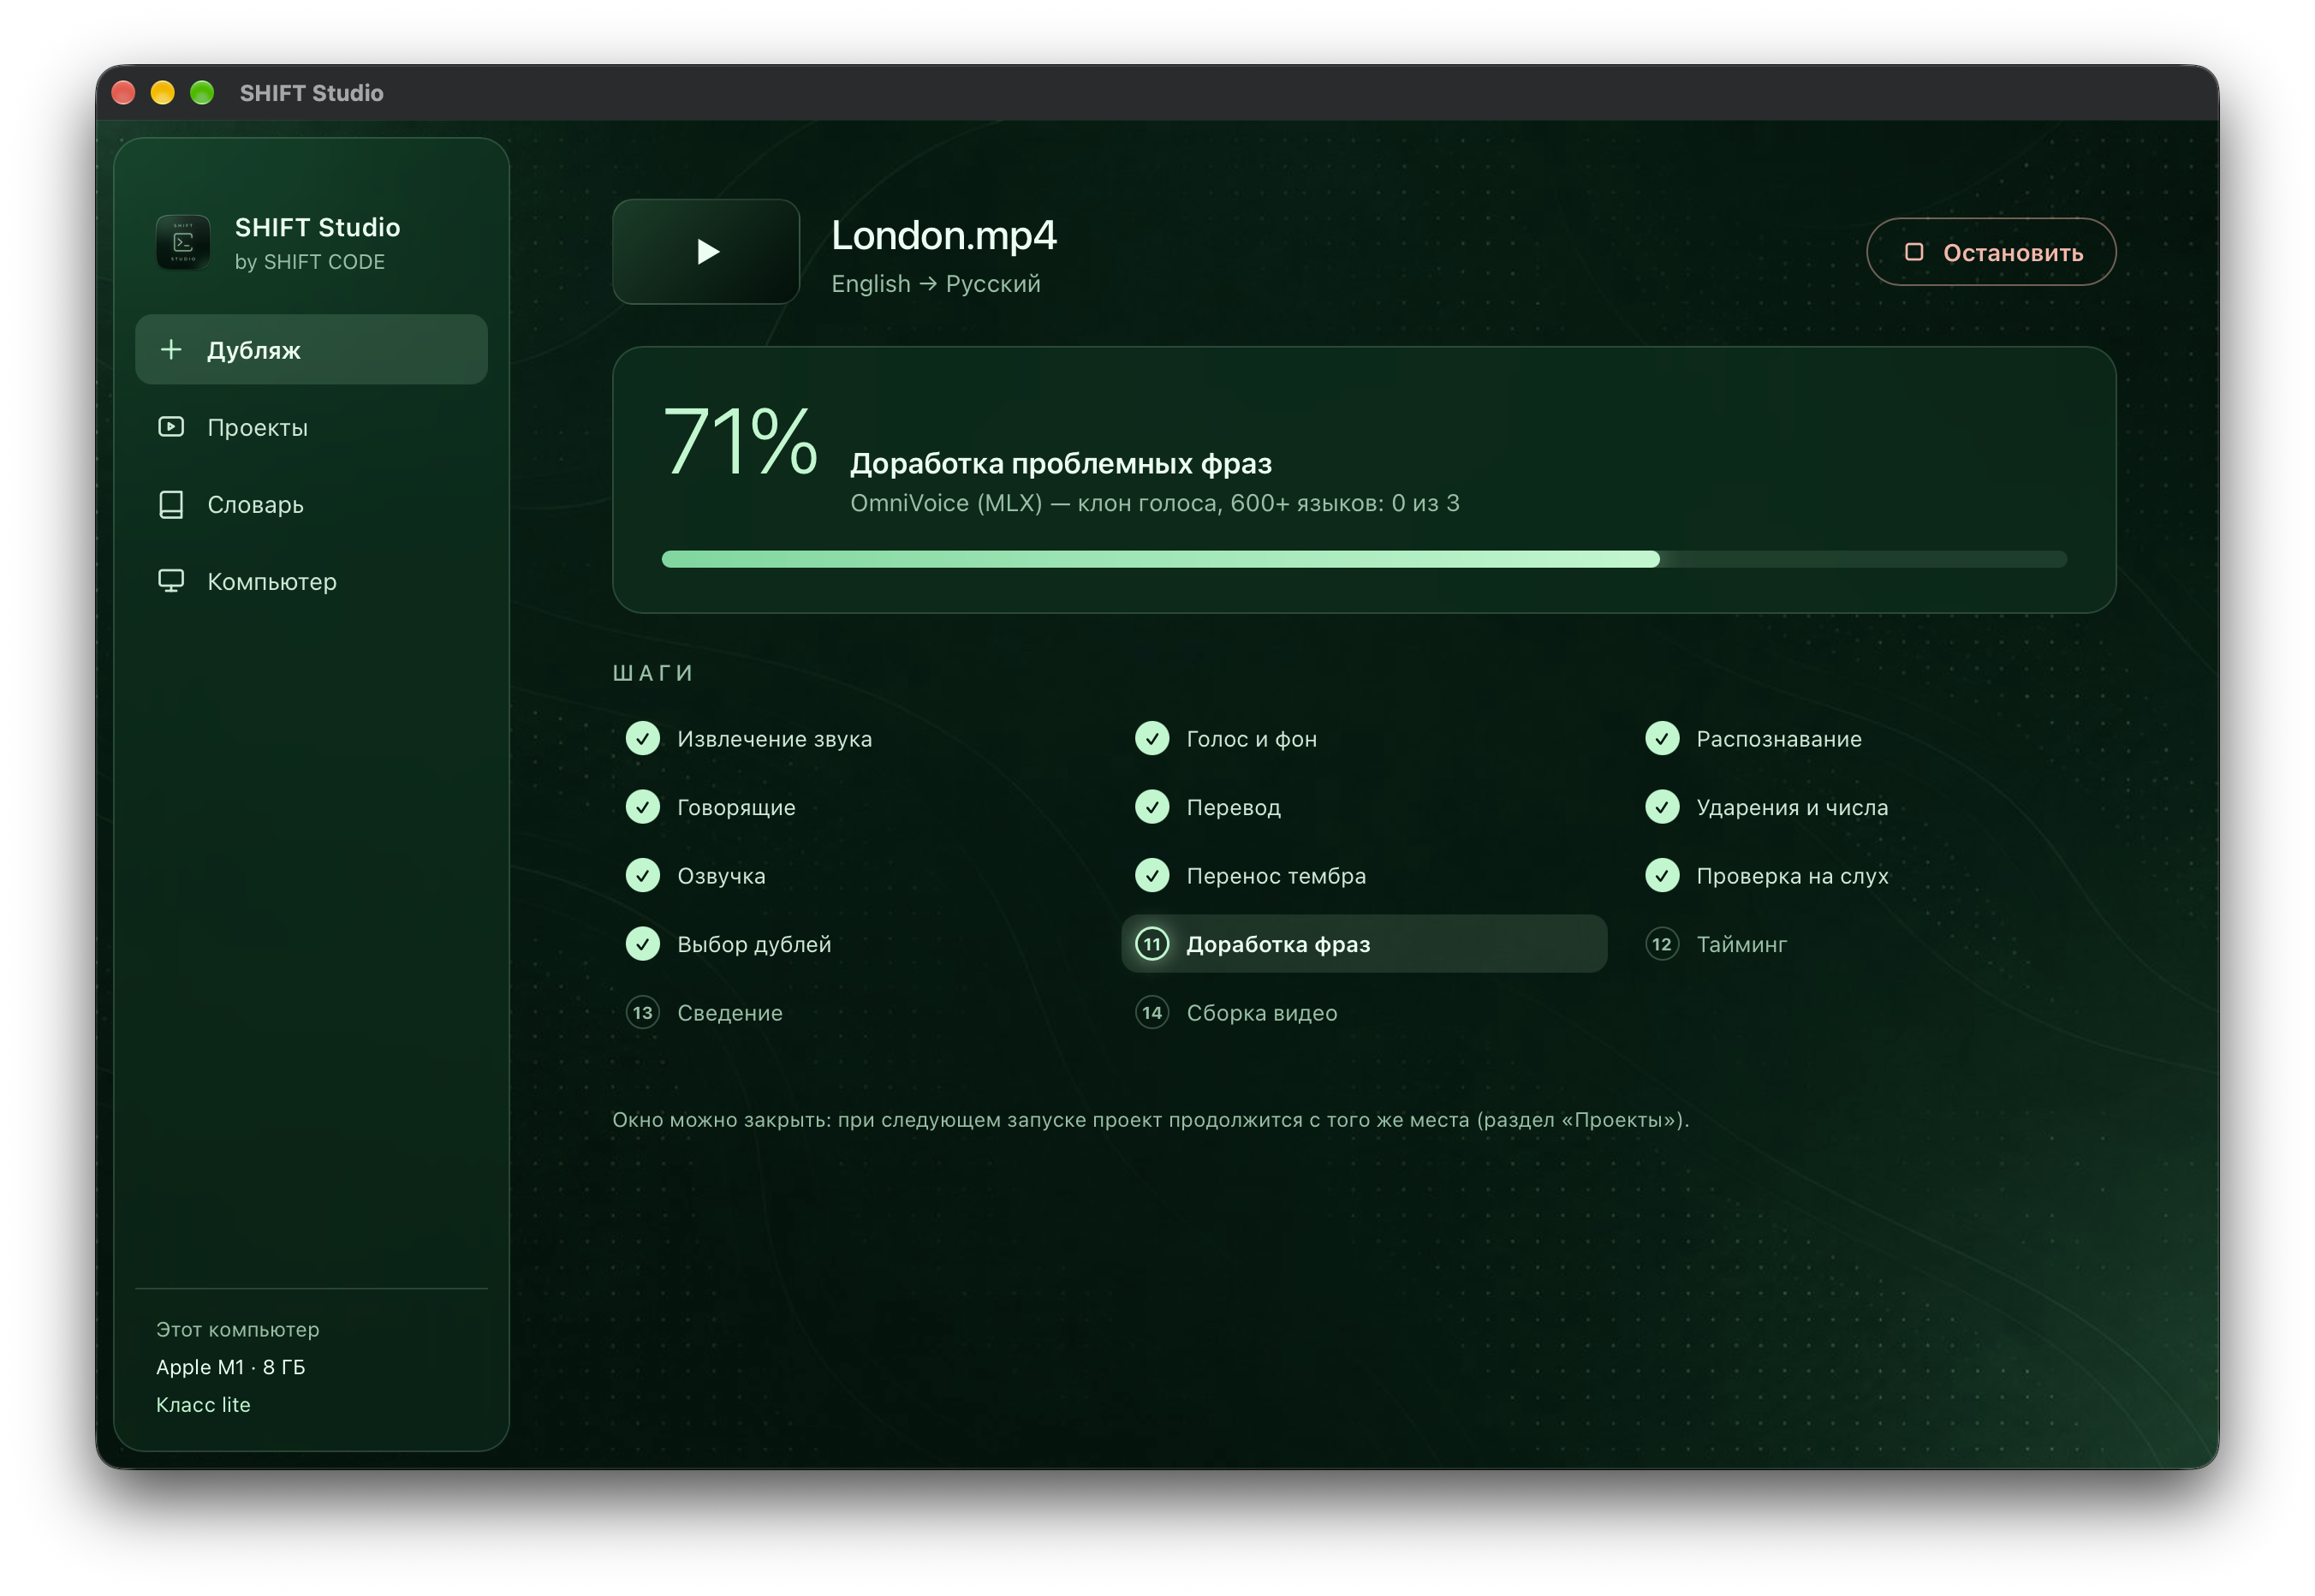
Uvnitř pracuje zpracovatelský řetězec o třinácti krocích. Zvuk se vyjme z videa, hlas se oddělí od pozadí, řeč se přepíše s časovými značkami pro každé slovo a rozdělí mezi mluvčí, poté se přeloží s ohledem na kontext a délku věty, dostane správný přízvuk a nadabuje se. Každá věta se syntetizuje v několika variantách různými enginy; každá varianta se znovu přepíše a porovná s textem a hlas se porovná s originálem. Program sám vybere nejlepší záběr, znovu nadabuje nesrozumitelné věty a zkrátí příliš dlouhé, přizpůsobí časování pauzám originálu a smíchá hlasitost s pozadím. Překlad lze podle potřeby před dabingem upravit a kteroukoli větu si poslechnout a znovu nadabovat samostatně. Každý krok běží v samostatném procesu a model se po dokončení zcela uvolní z paměti, takže i počítač s 8 GB může používat modely, které by se do paměti společně nikdy nevešly. Vše funguje offline: internet je potřeba jen jednou, ke stažení modelů.
K oddělení hlasu slouží Demucs, k rozpoznávání řeči a kontrole dabingu Whisper large-v3 a large-v3 turbo a k rozpoznání mluvčích ECAPA-TDNN ze SpeechBrain. Překlad zajišťují jazykové modely Gemma 3 a Qwen3 nebo NLLB-200, přízvuky určují RUAccent a ukrainian-word-stress. Hlas syntetizují OmniVoice, KugelAudio, XTTS-v2 a Silero a barvu hlasu přenáší kNN-VC. Všechny modely jsou popsány v rozšiřitelném katalogu, takže nový model lze přidat jediným záznamem a program sám rozhodne, zda se hodí pro počítač uživatele.
Program je napsán v Pythonu. Část s umělou inteligencí stojí na PyTorch, Hugging Face Transformers a SpeechBrain; na Macu výpočty urychluje Apple MLX se 4bitovými jazykovými modely, ve Windows CUDA na grafických kartách NVIDIA. O zpracování zvuku a videa se starají ffmpeg, Rubber Band a librosa. Desktopová aplikace je postavena na pywebview s rozhraním v HTML, CSS a JavaScriptu ve firemním stylu SHIFT CODE a k dispozici je i plnohodnotný příkazový řádek. Instalátory jsou napsány v Bash a PowerShellu se správcem prostředí uv a celý řetězec je pokryt testy v pytest.
Výsledkem je multiplatformní aplikace, která sama vybere a nainstaluje více než 25 modelů neuronových sítí pro konkrétní počítač, běží zcela lokálně a dabuje mezi 12 jazyky jediným krokem.