Задача
SHIFT Studio - локальная студия нейросетевого дубляжа видео для Mac на Apple Silicon и Windows.
Нейросетевой дубляж обычно требует целого набора моделей: для распознавания речи, перевода, синтеза голоса, клонирования тембра и отделения голоса от музыки. Каждую нужно найти, установить, подобрать под своё железо и связать с остальными, а это работа для инженера, а не для автора видео. Облачные сервисы решают эту проблему, но они платные, ограничены по времени и требуют загружать материалы на чужие серверы. Цель проекта - сделать дубляж доступным человеку без технических знаний: он скачивает одну программу, и дальше ему достаточно перетащить видео в окно.
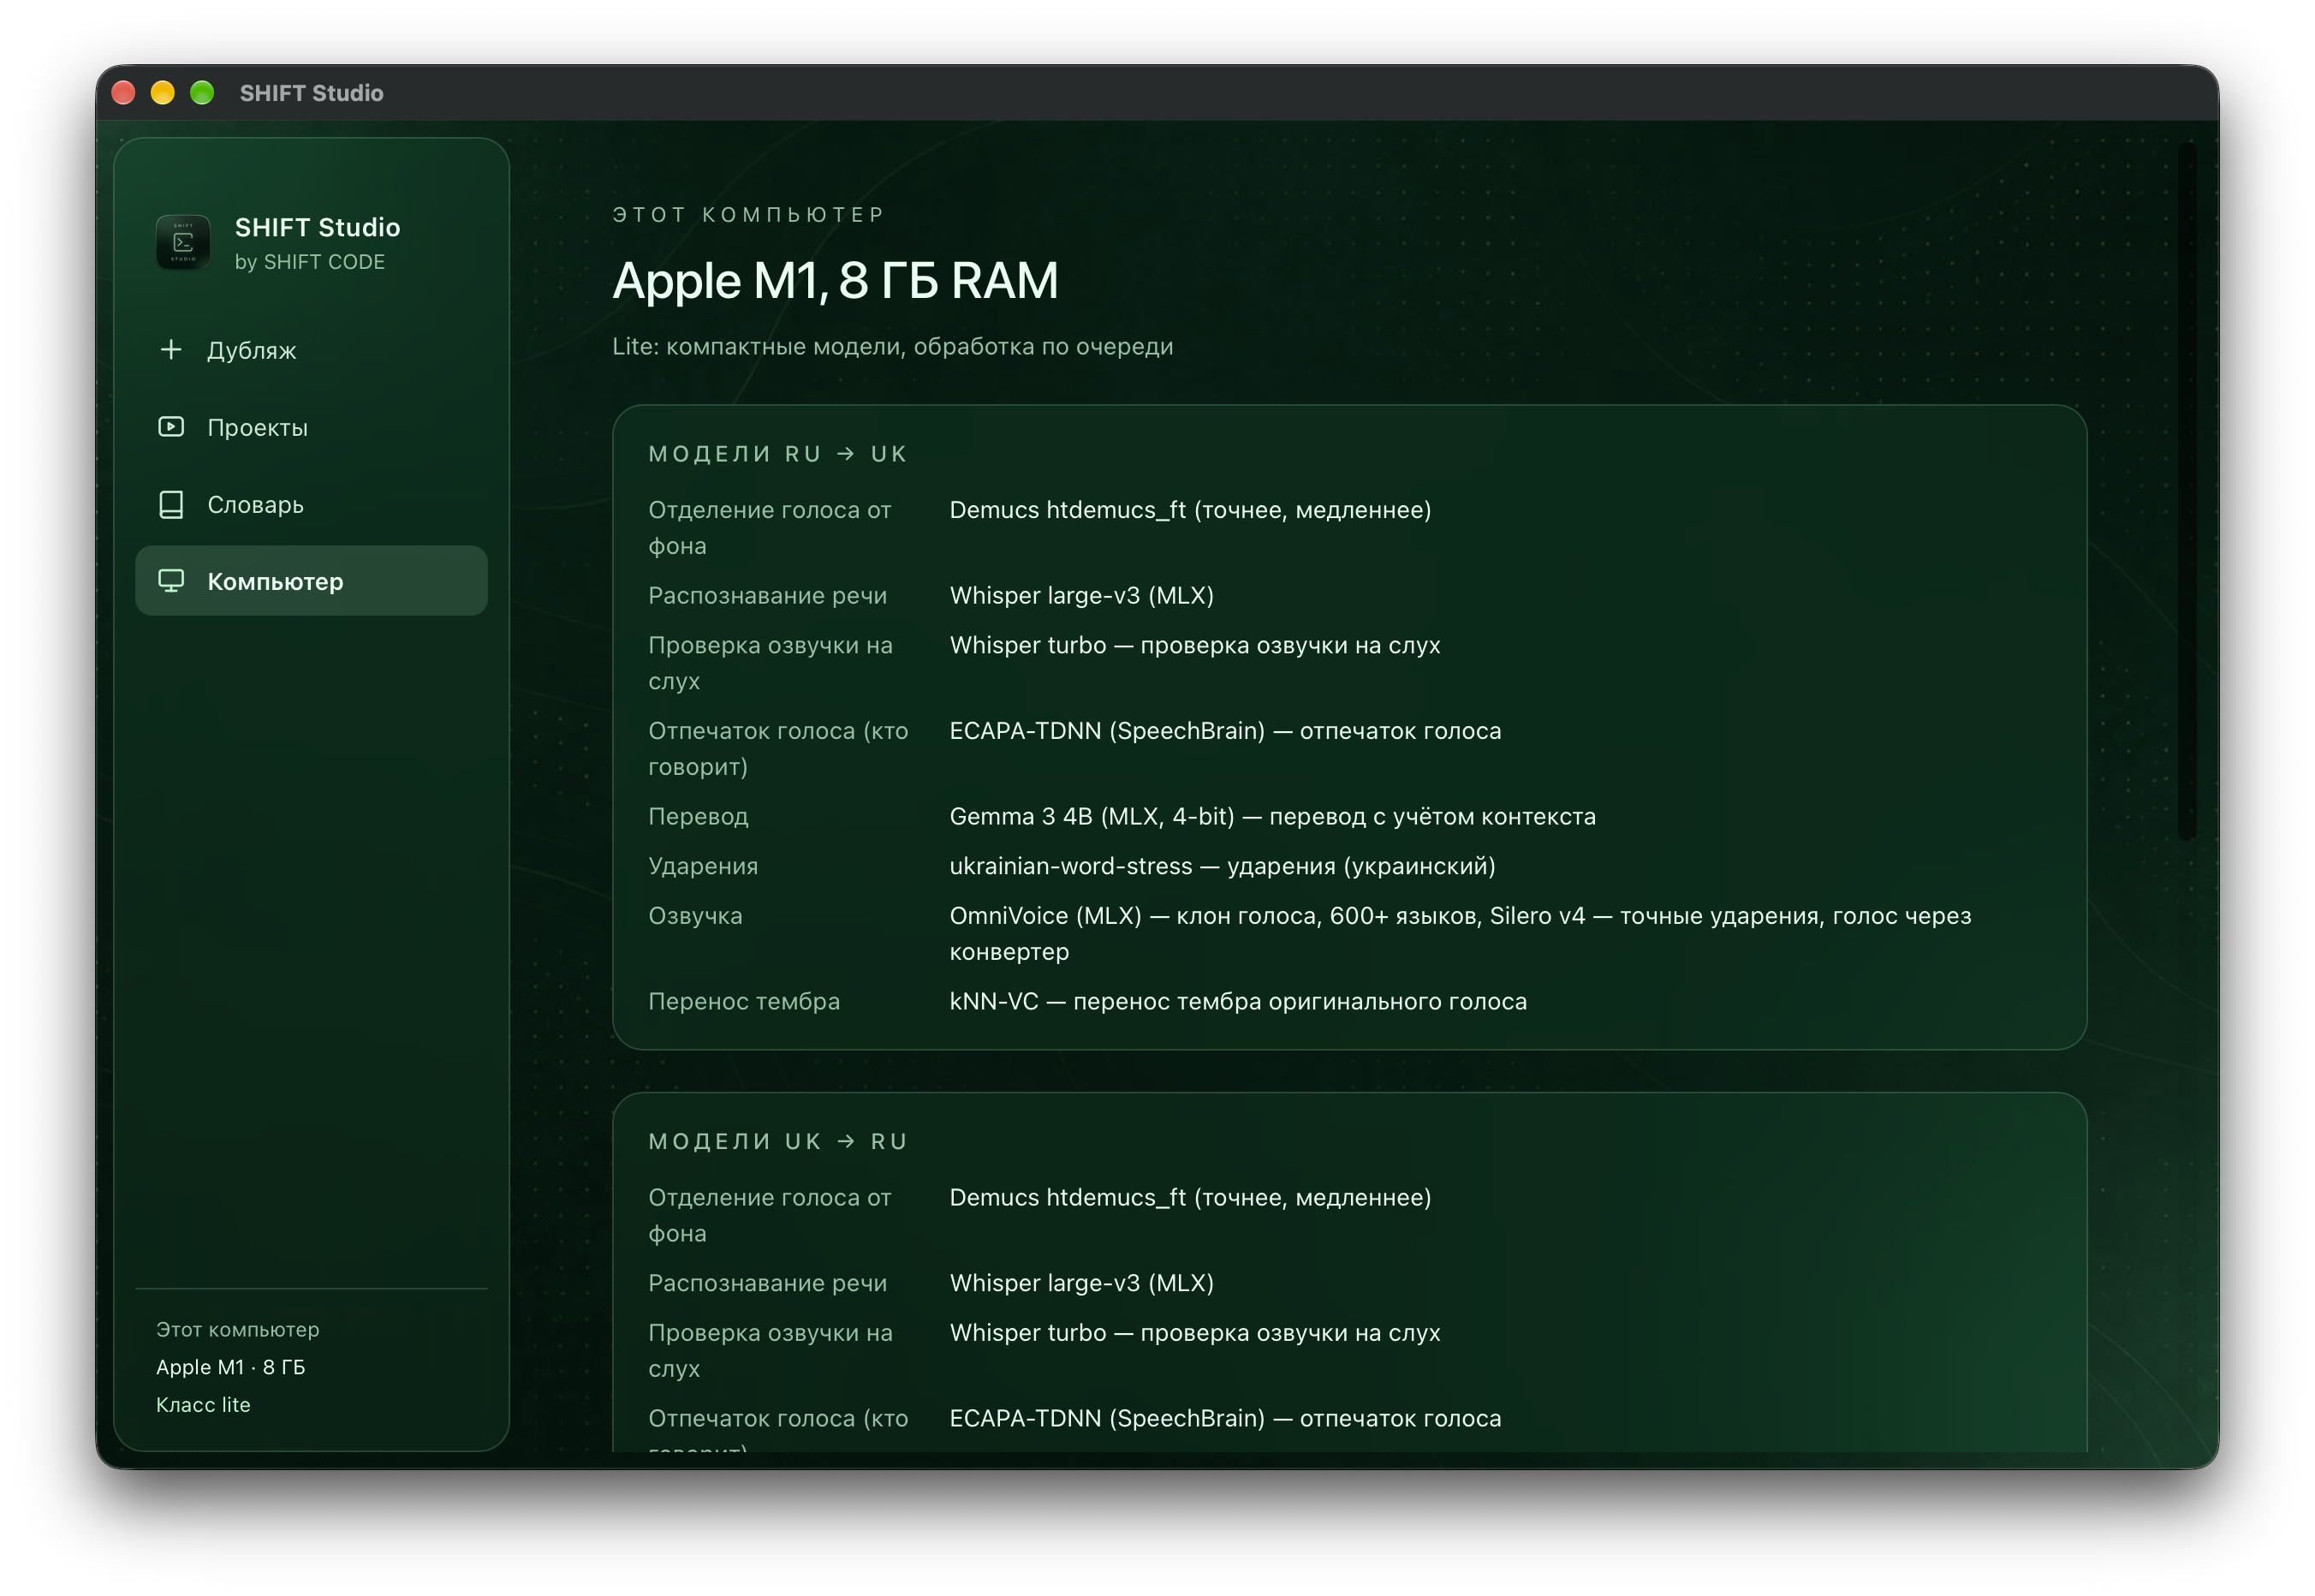
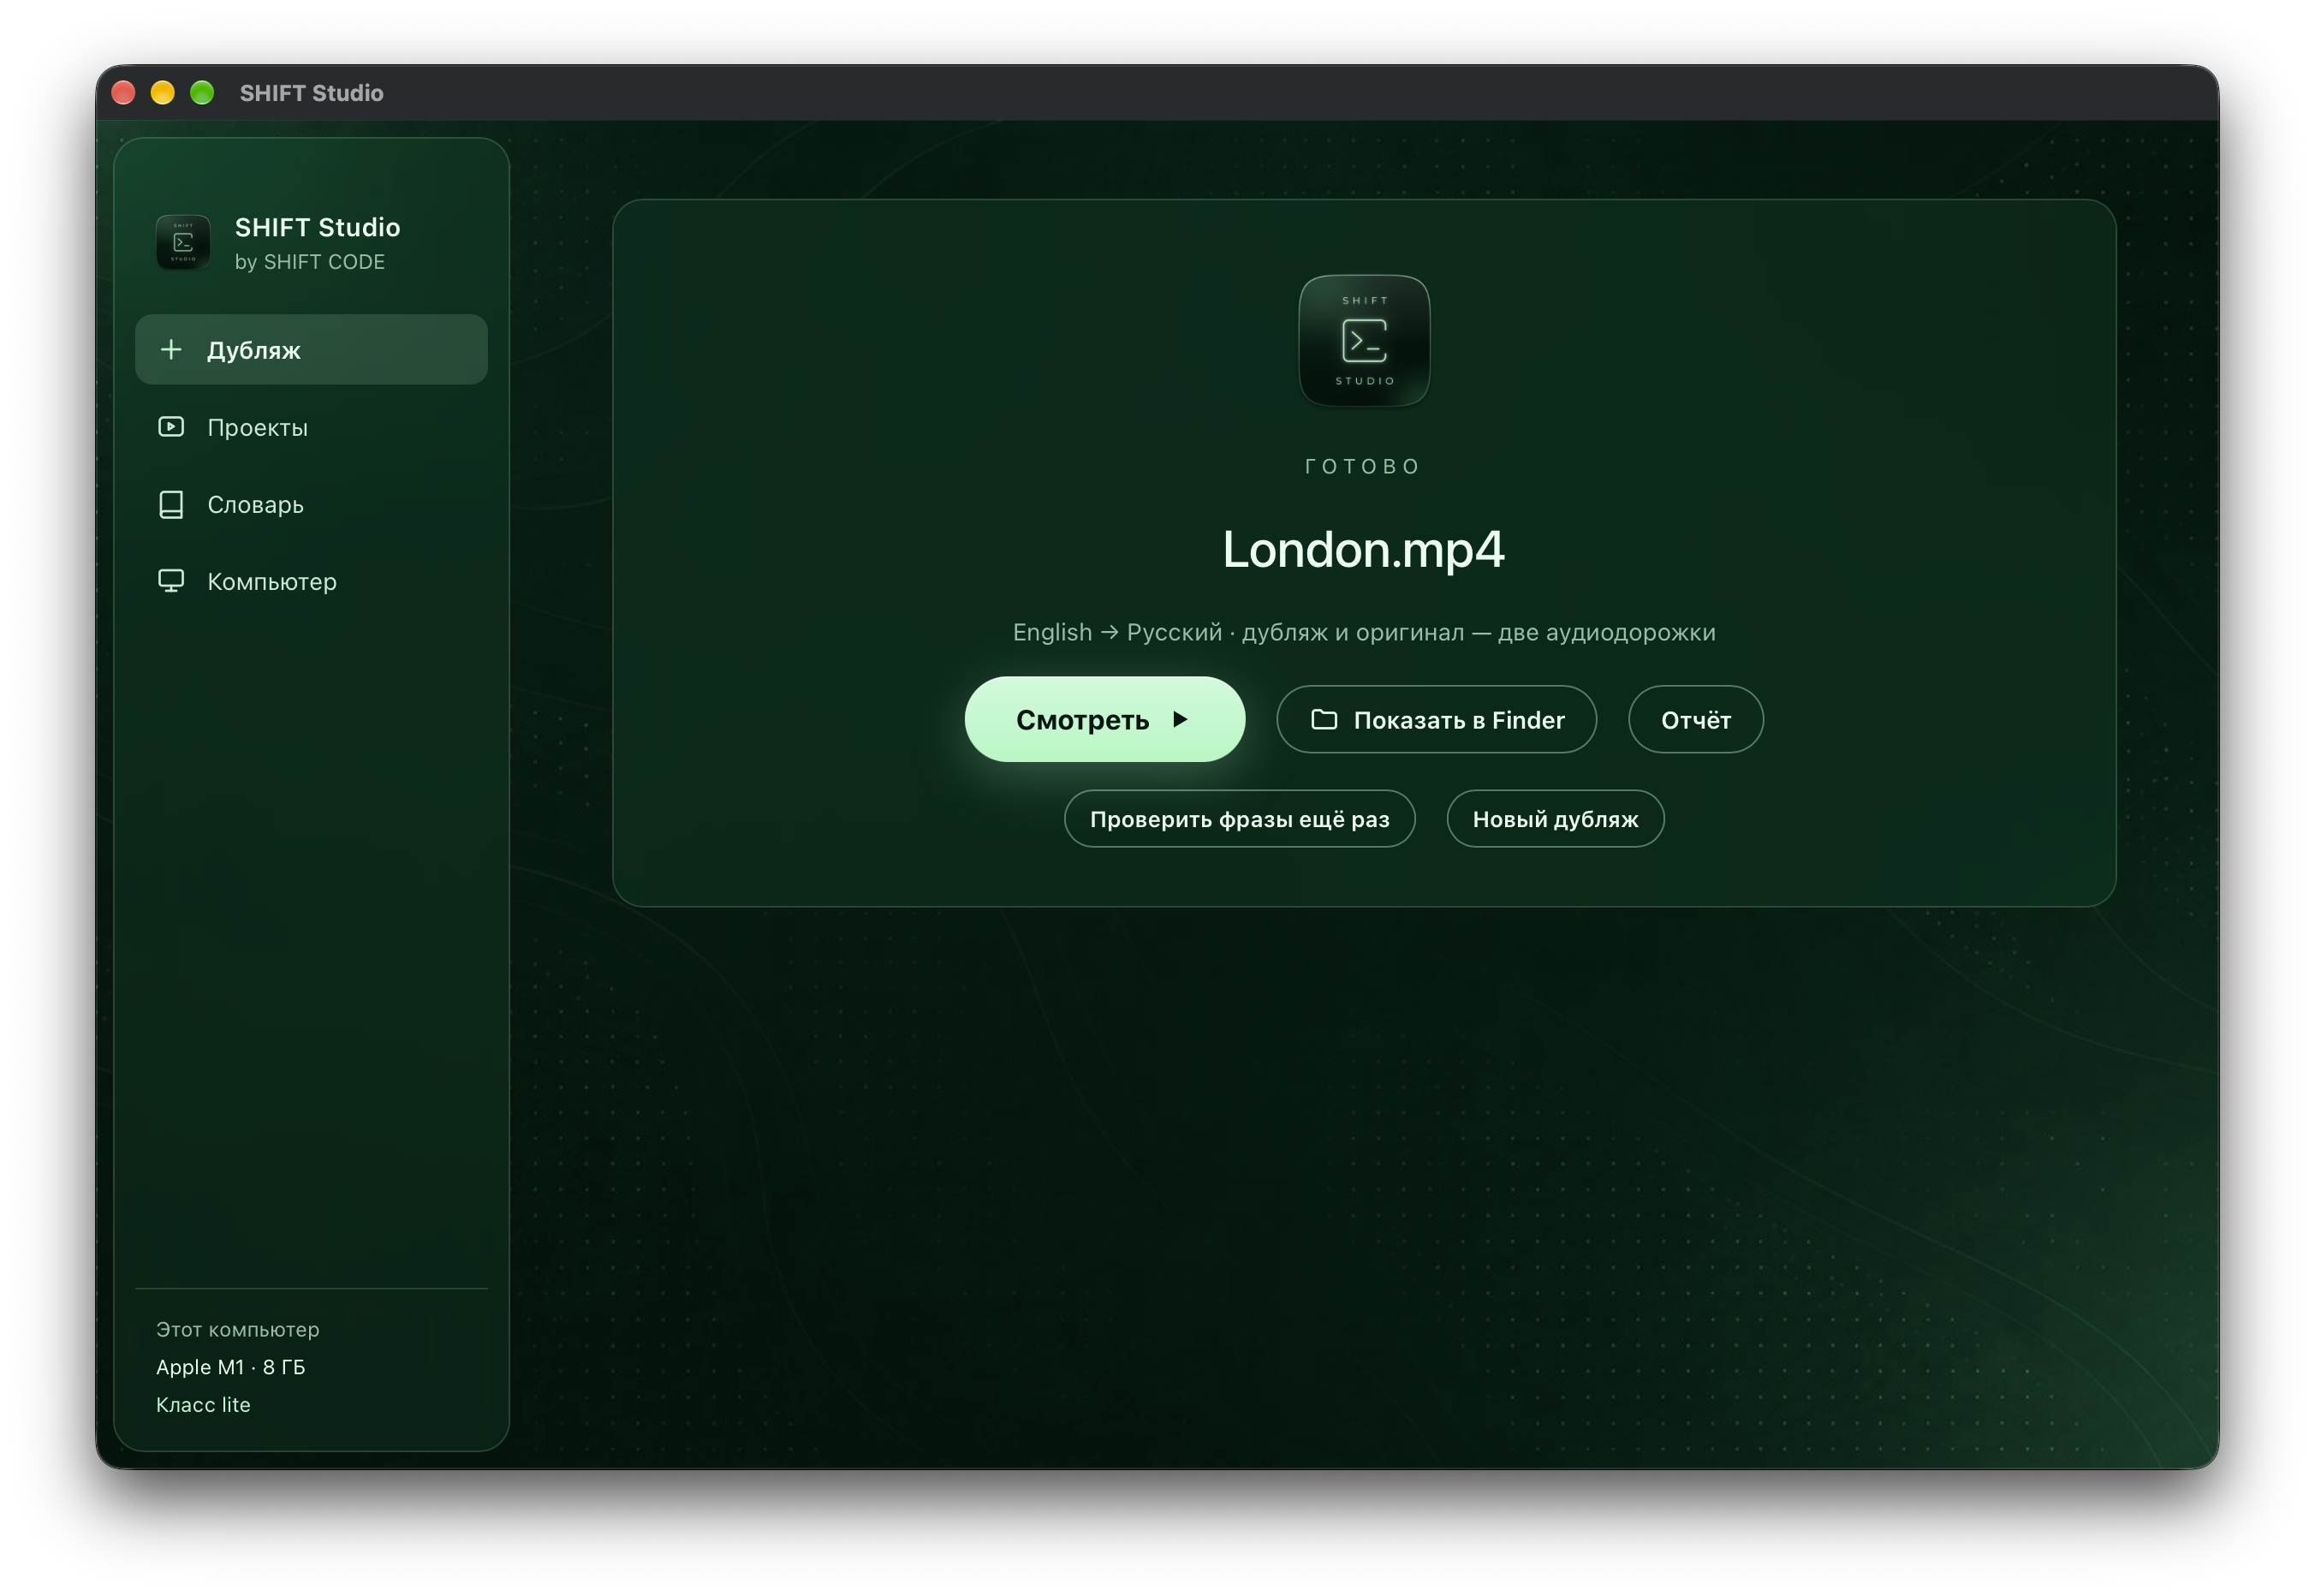
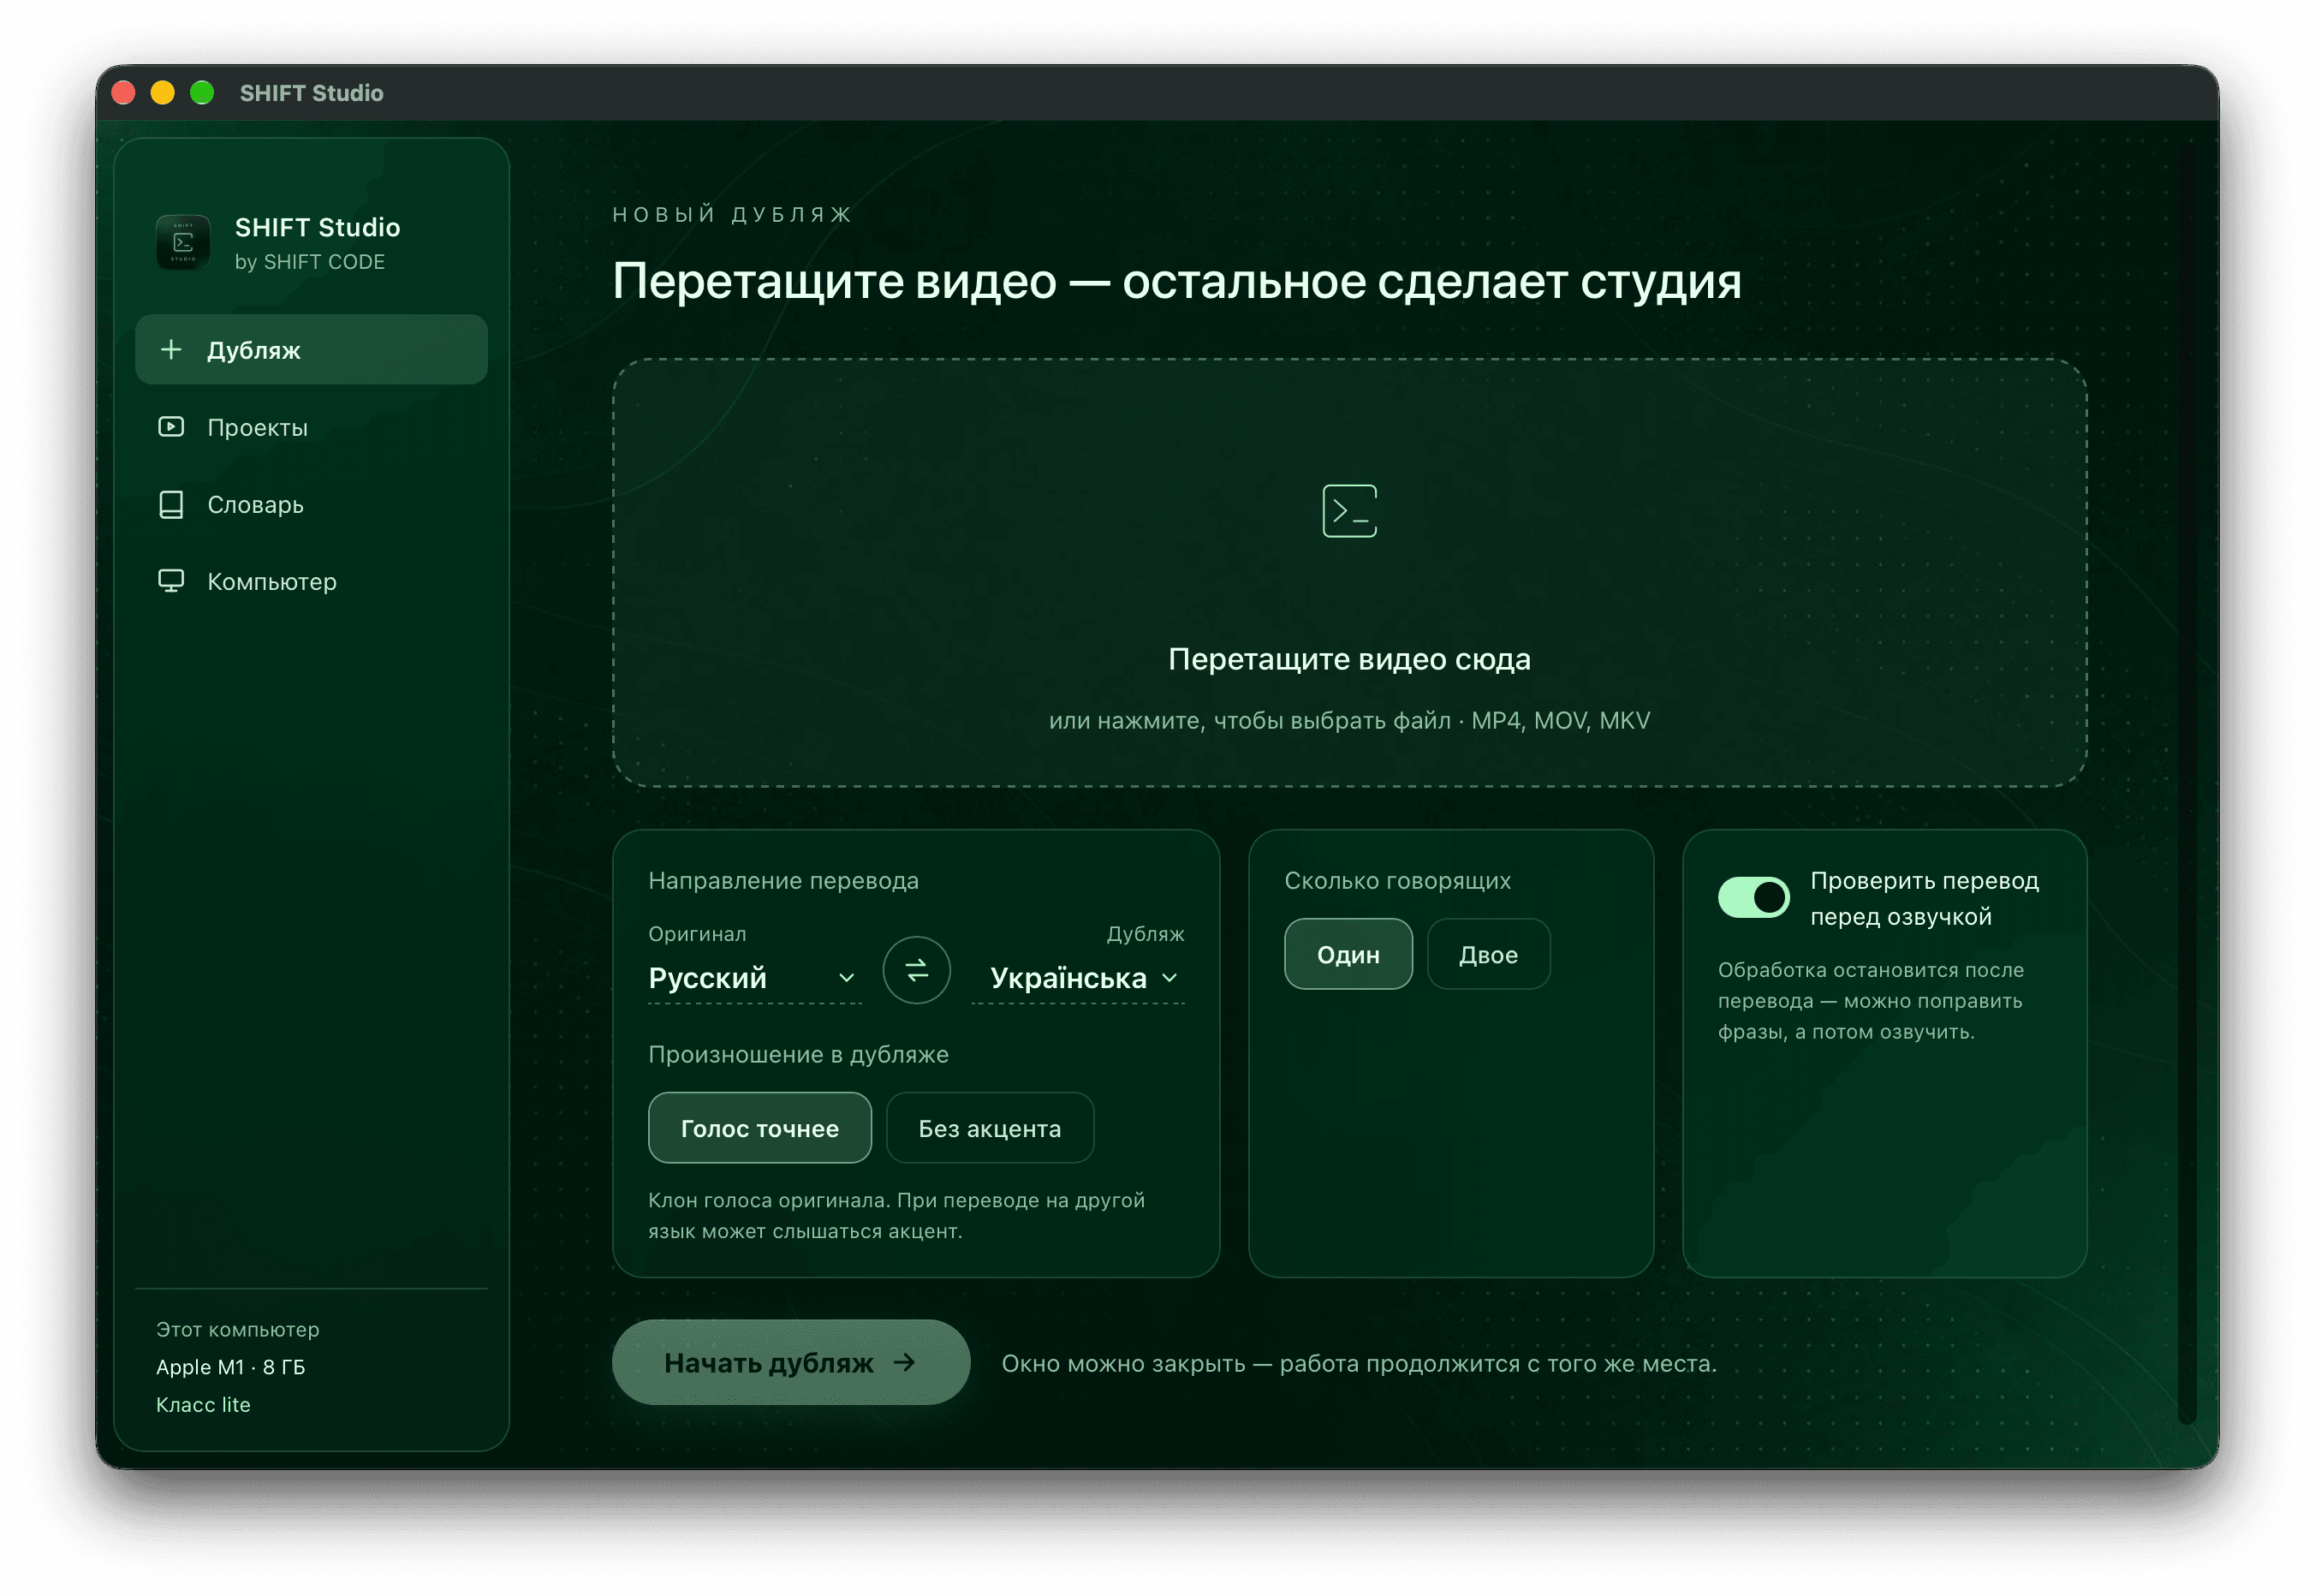
При установке программа сама определяет процессор, объём памяти и видеокарту, относит компьютер к одному из классов производительности и скачивает модели именно под него: на ноутбуке с 8 ГБ памяти - компактные, на мощной машине - самые большие и качественные. Пользователь выбирает только языки и число говорящих, а на выходе получает видео с переводом, озвученным голосом оригинального спикера точно по таймкодам, с сохранённой музыкой и фоном, субтитрами и оригинальной звуковой дорожкой. Для тех, кому важно чистое произношение, есть режим без акцента: озвучивает носитель языка, а тембр оригинала переносится отдельной моделью.
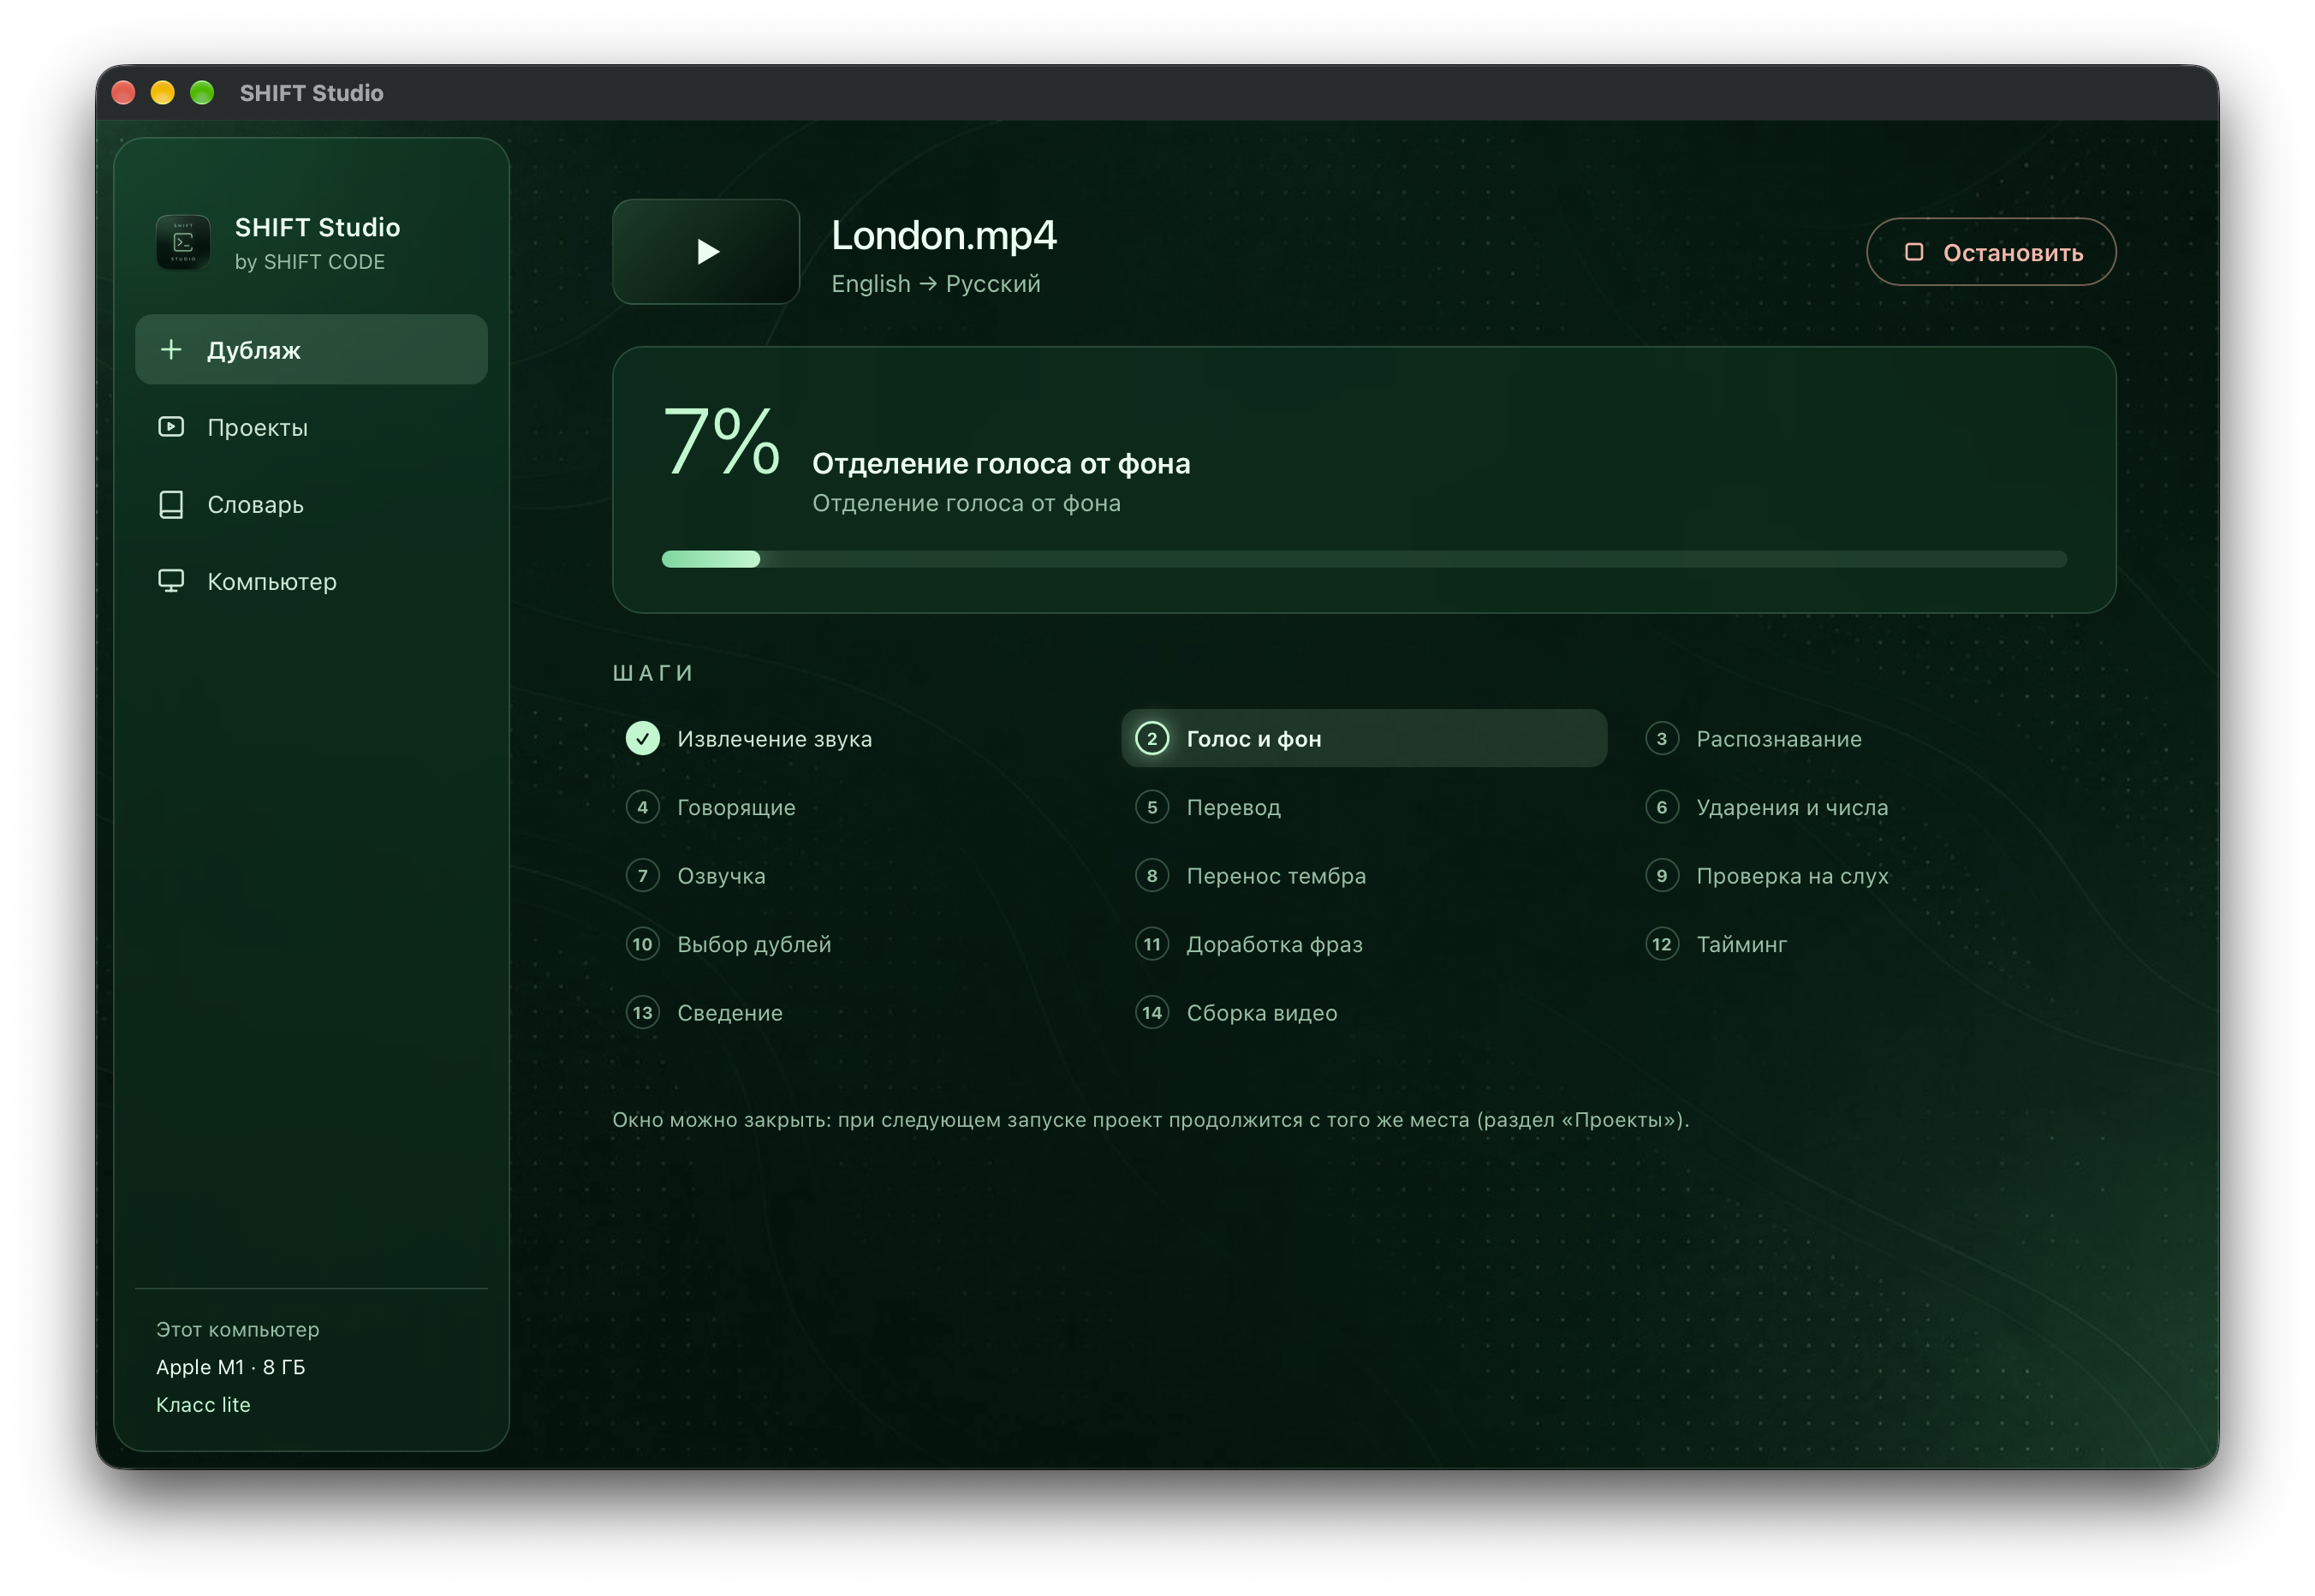
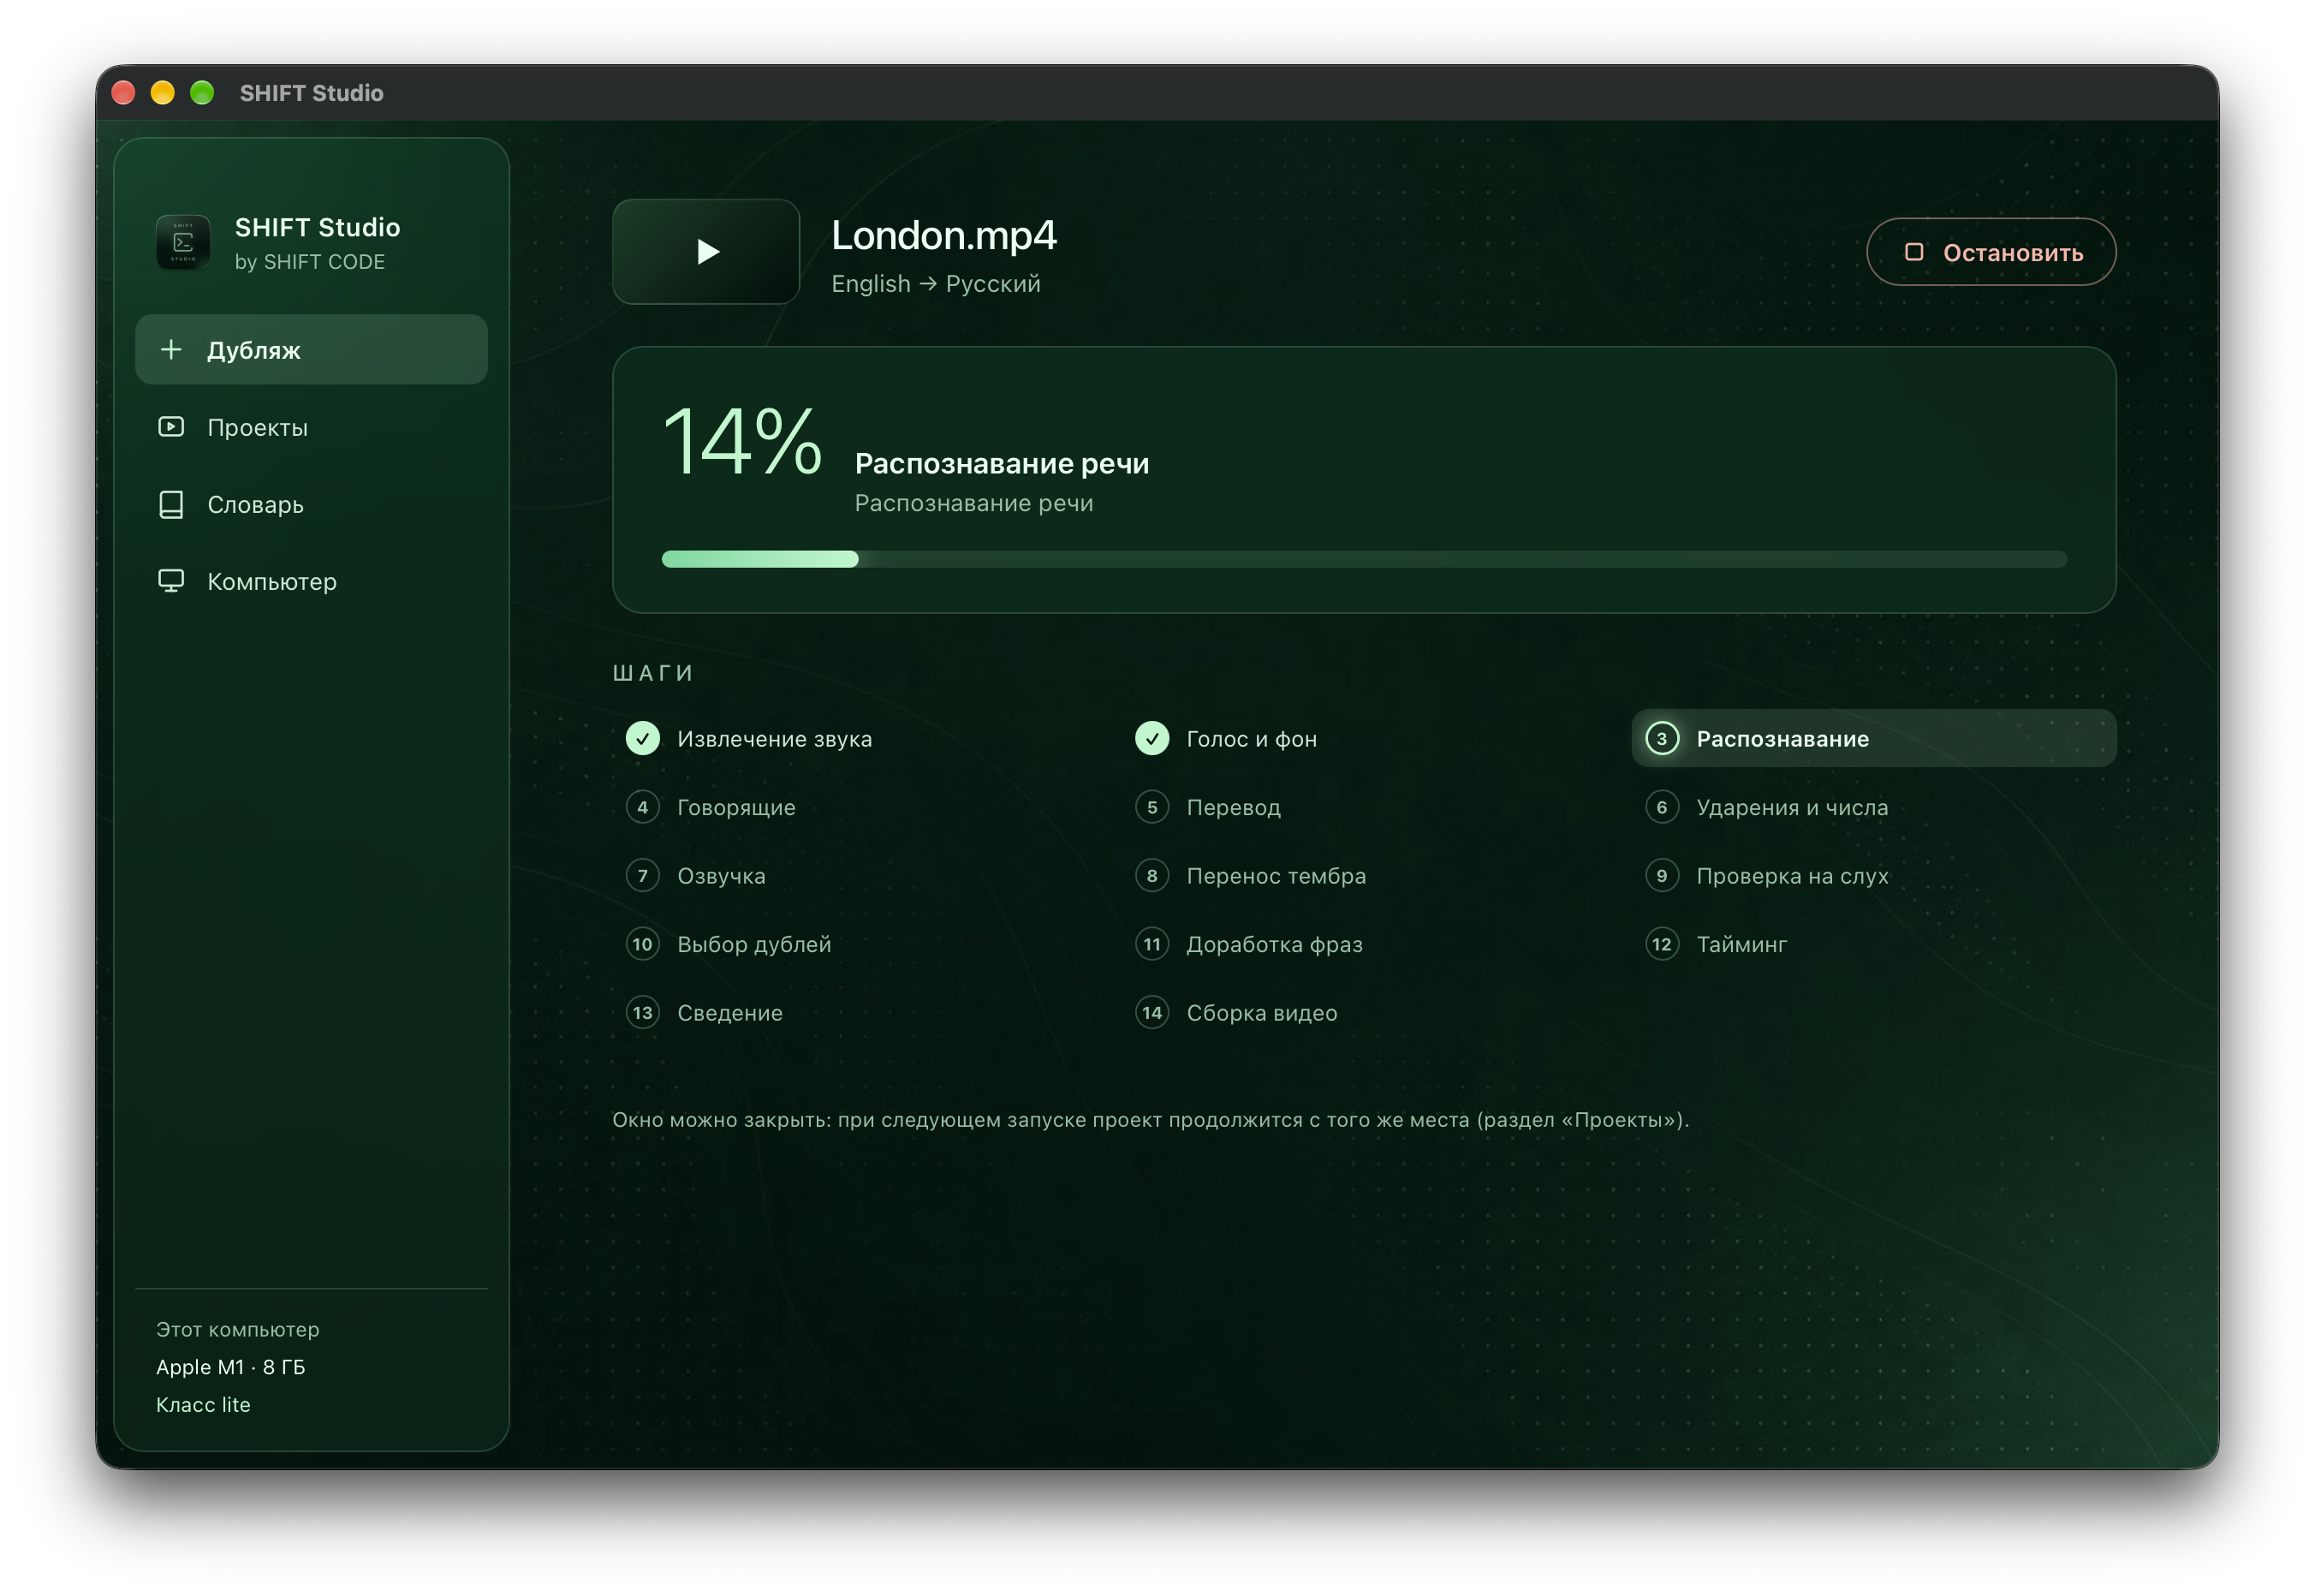
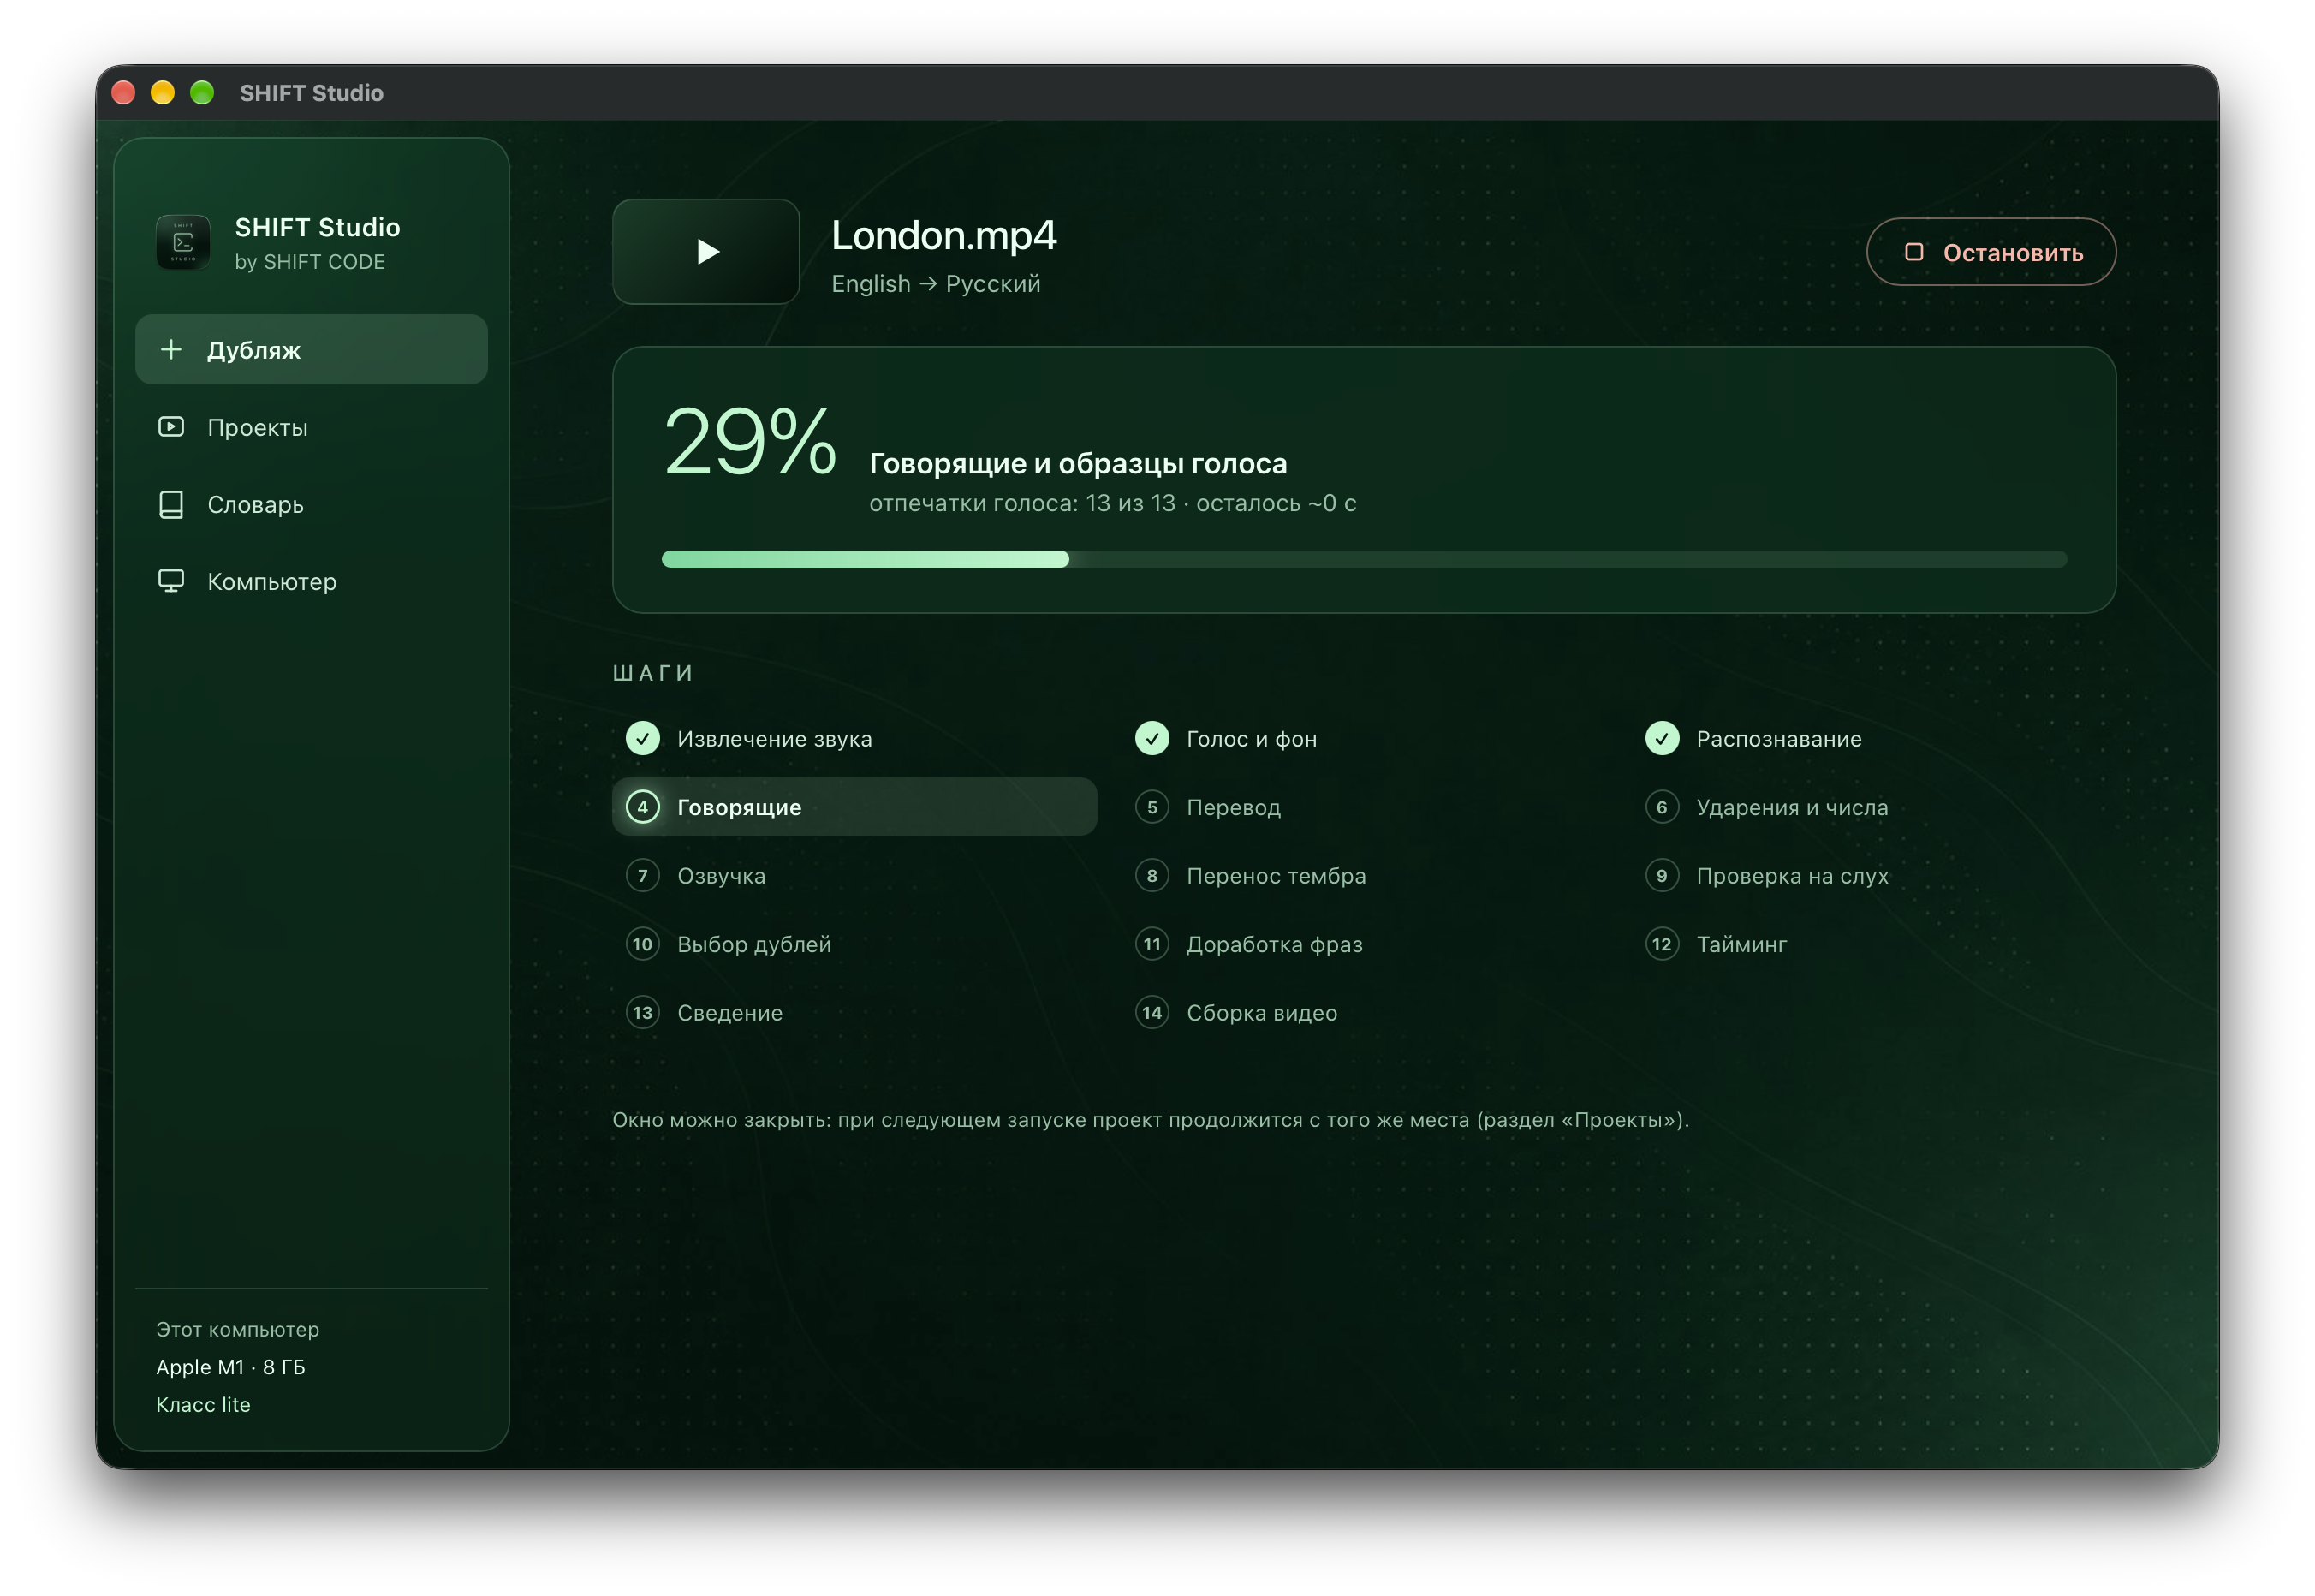
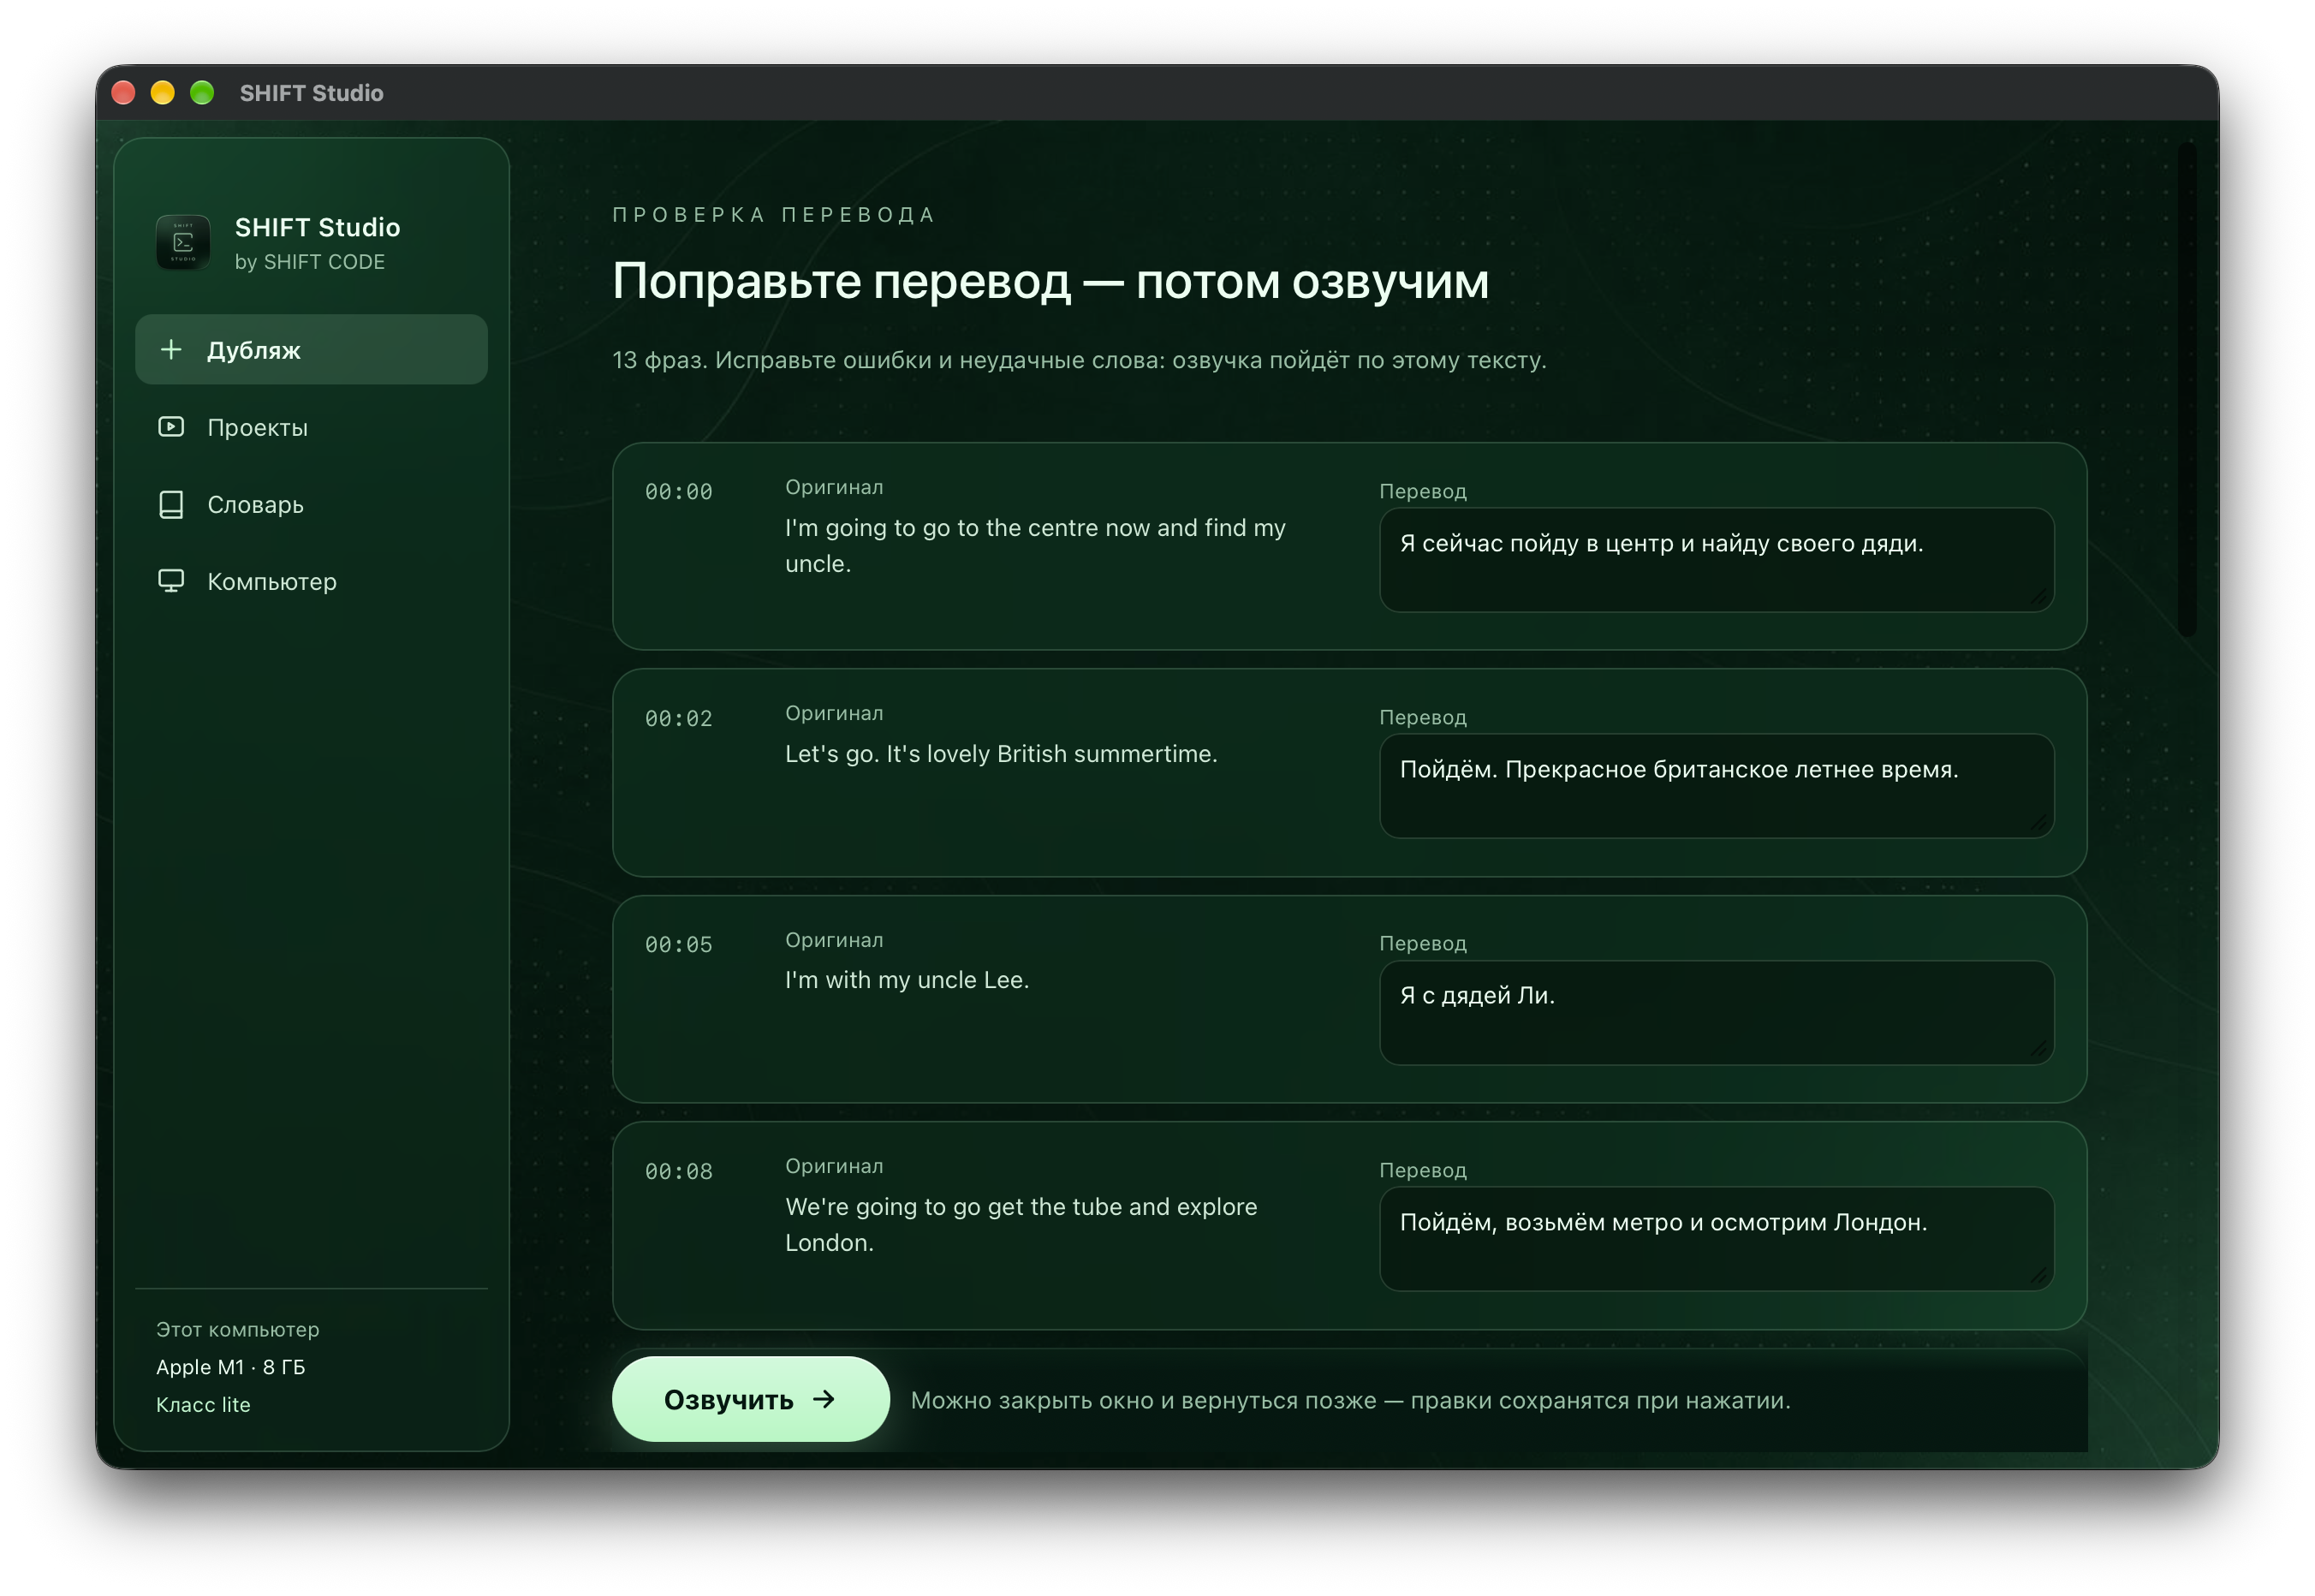
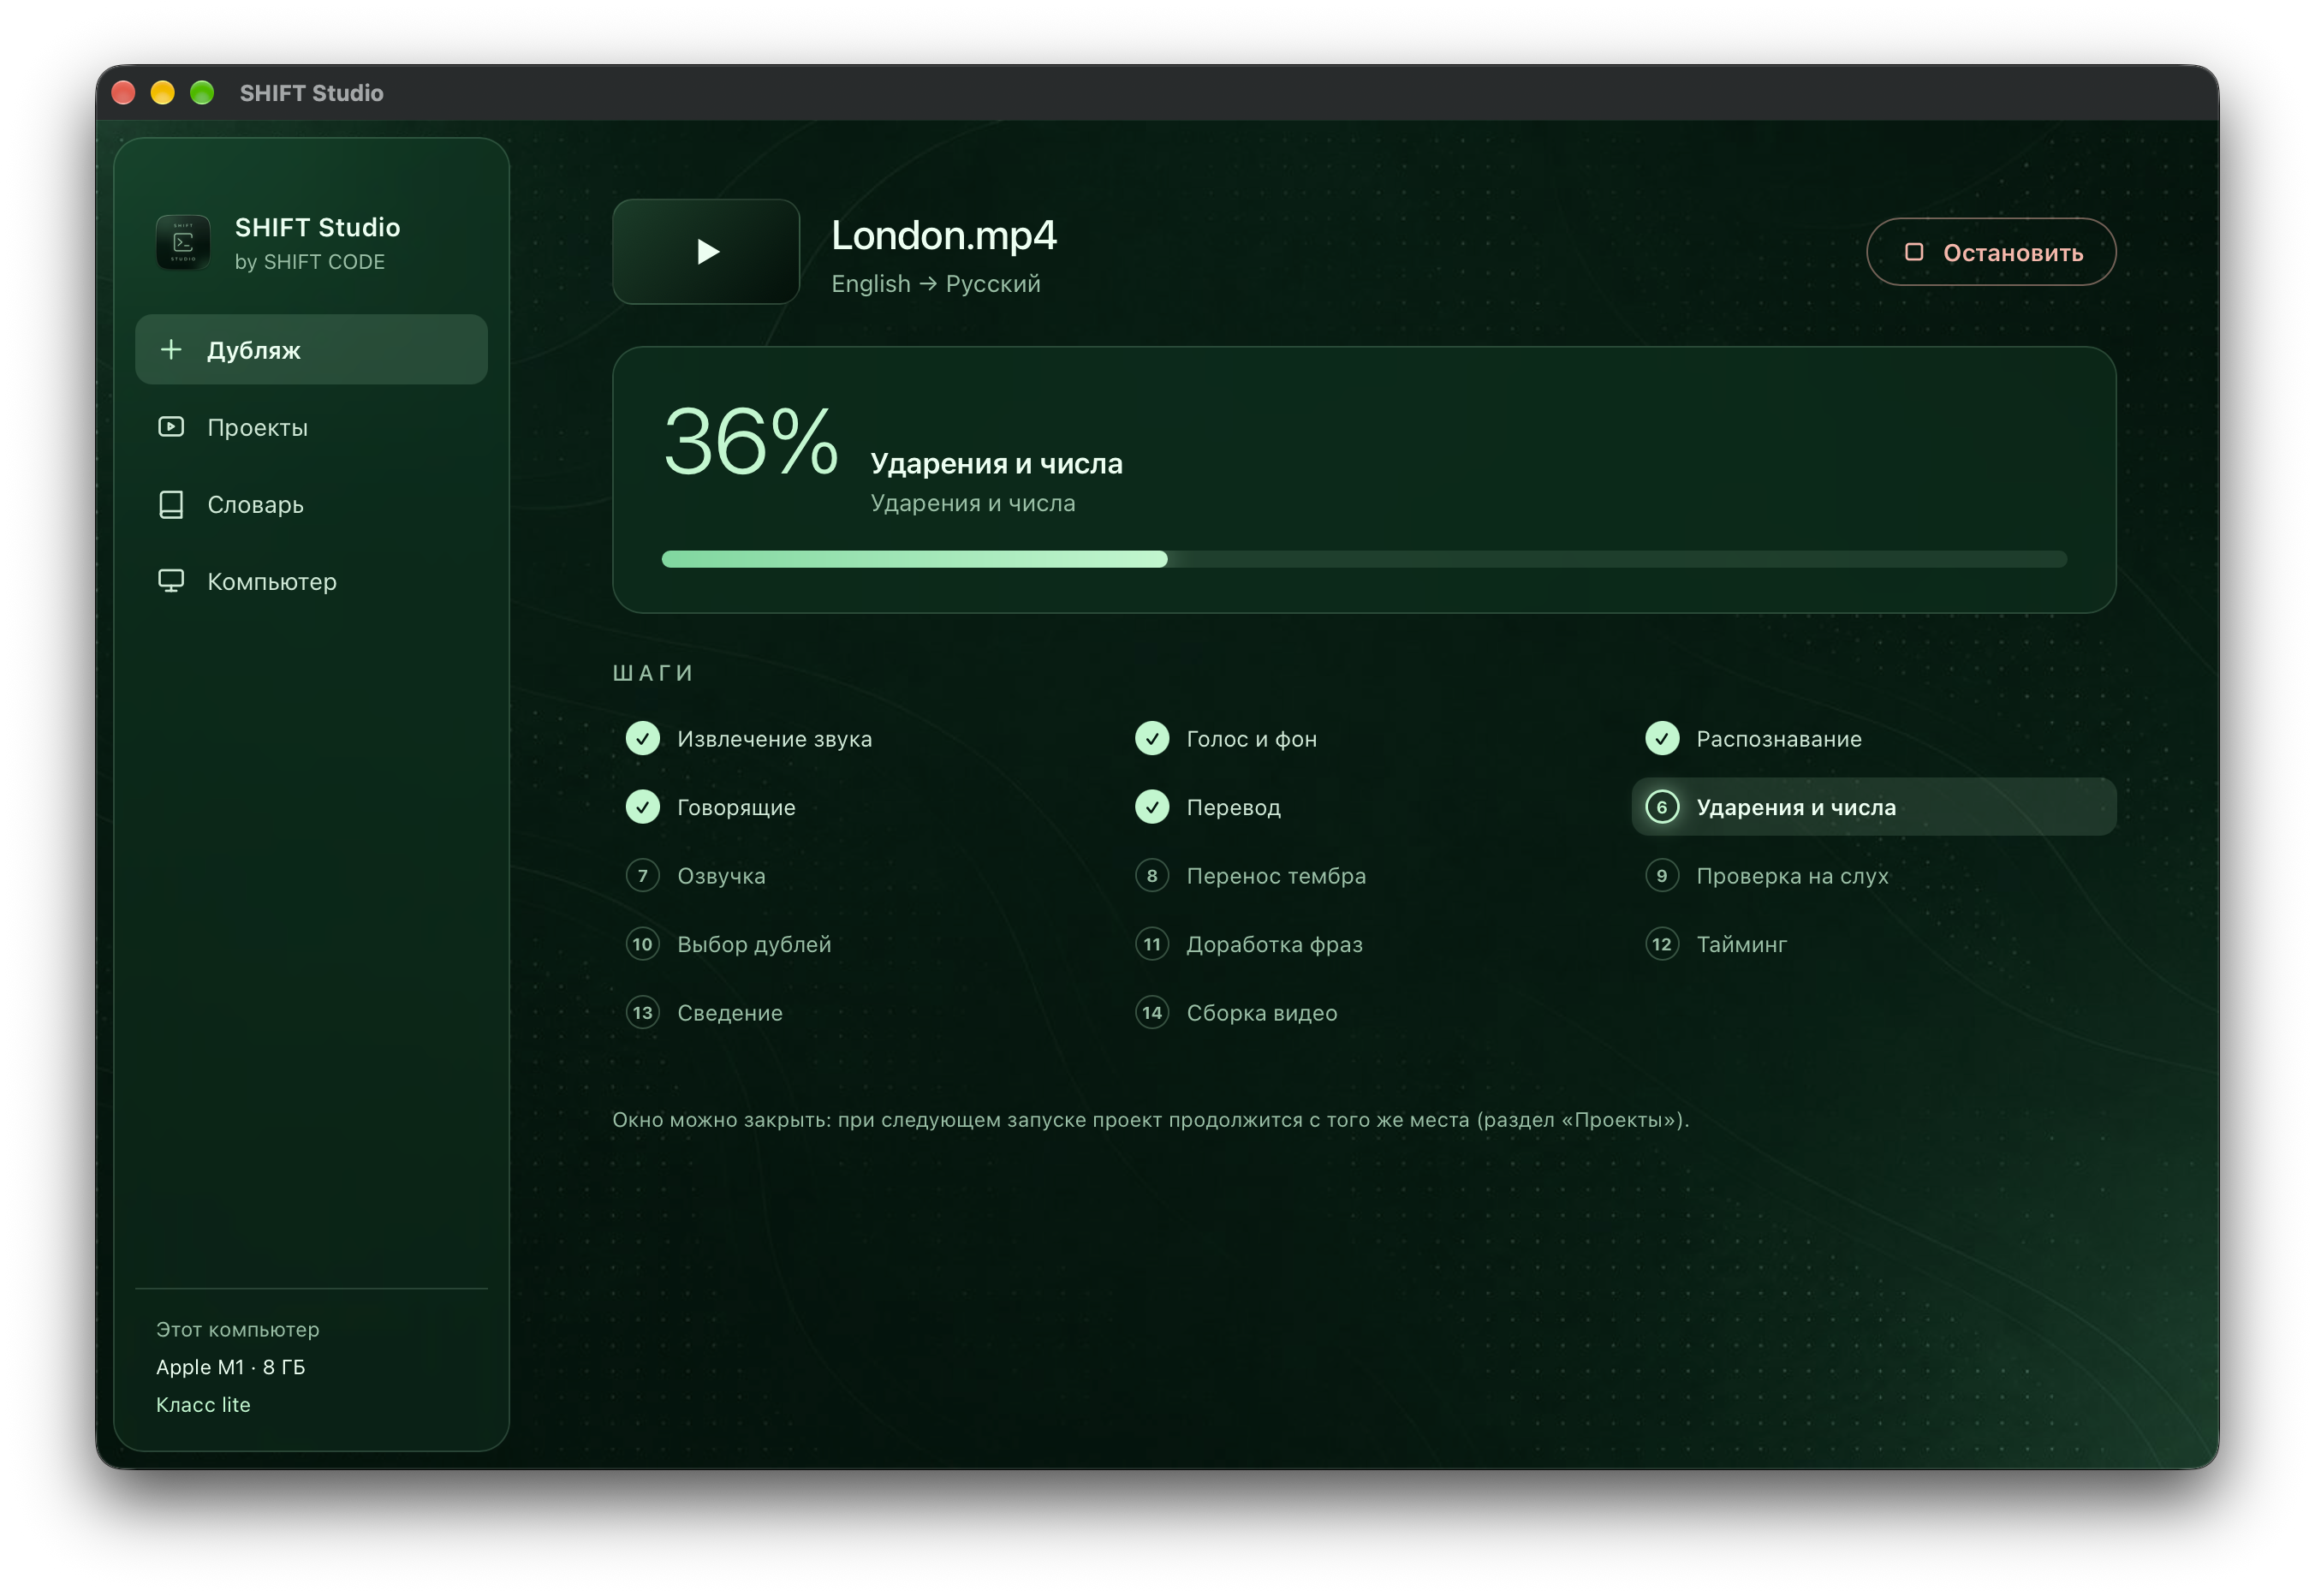
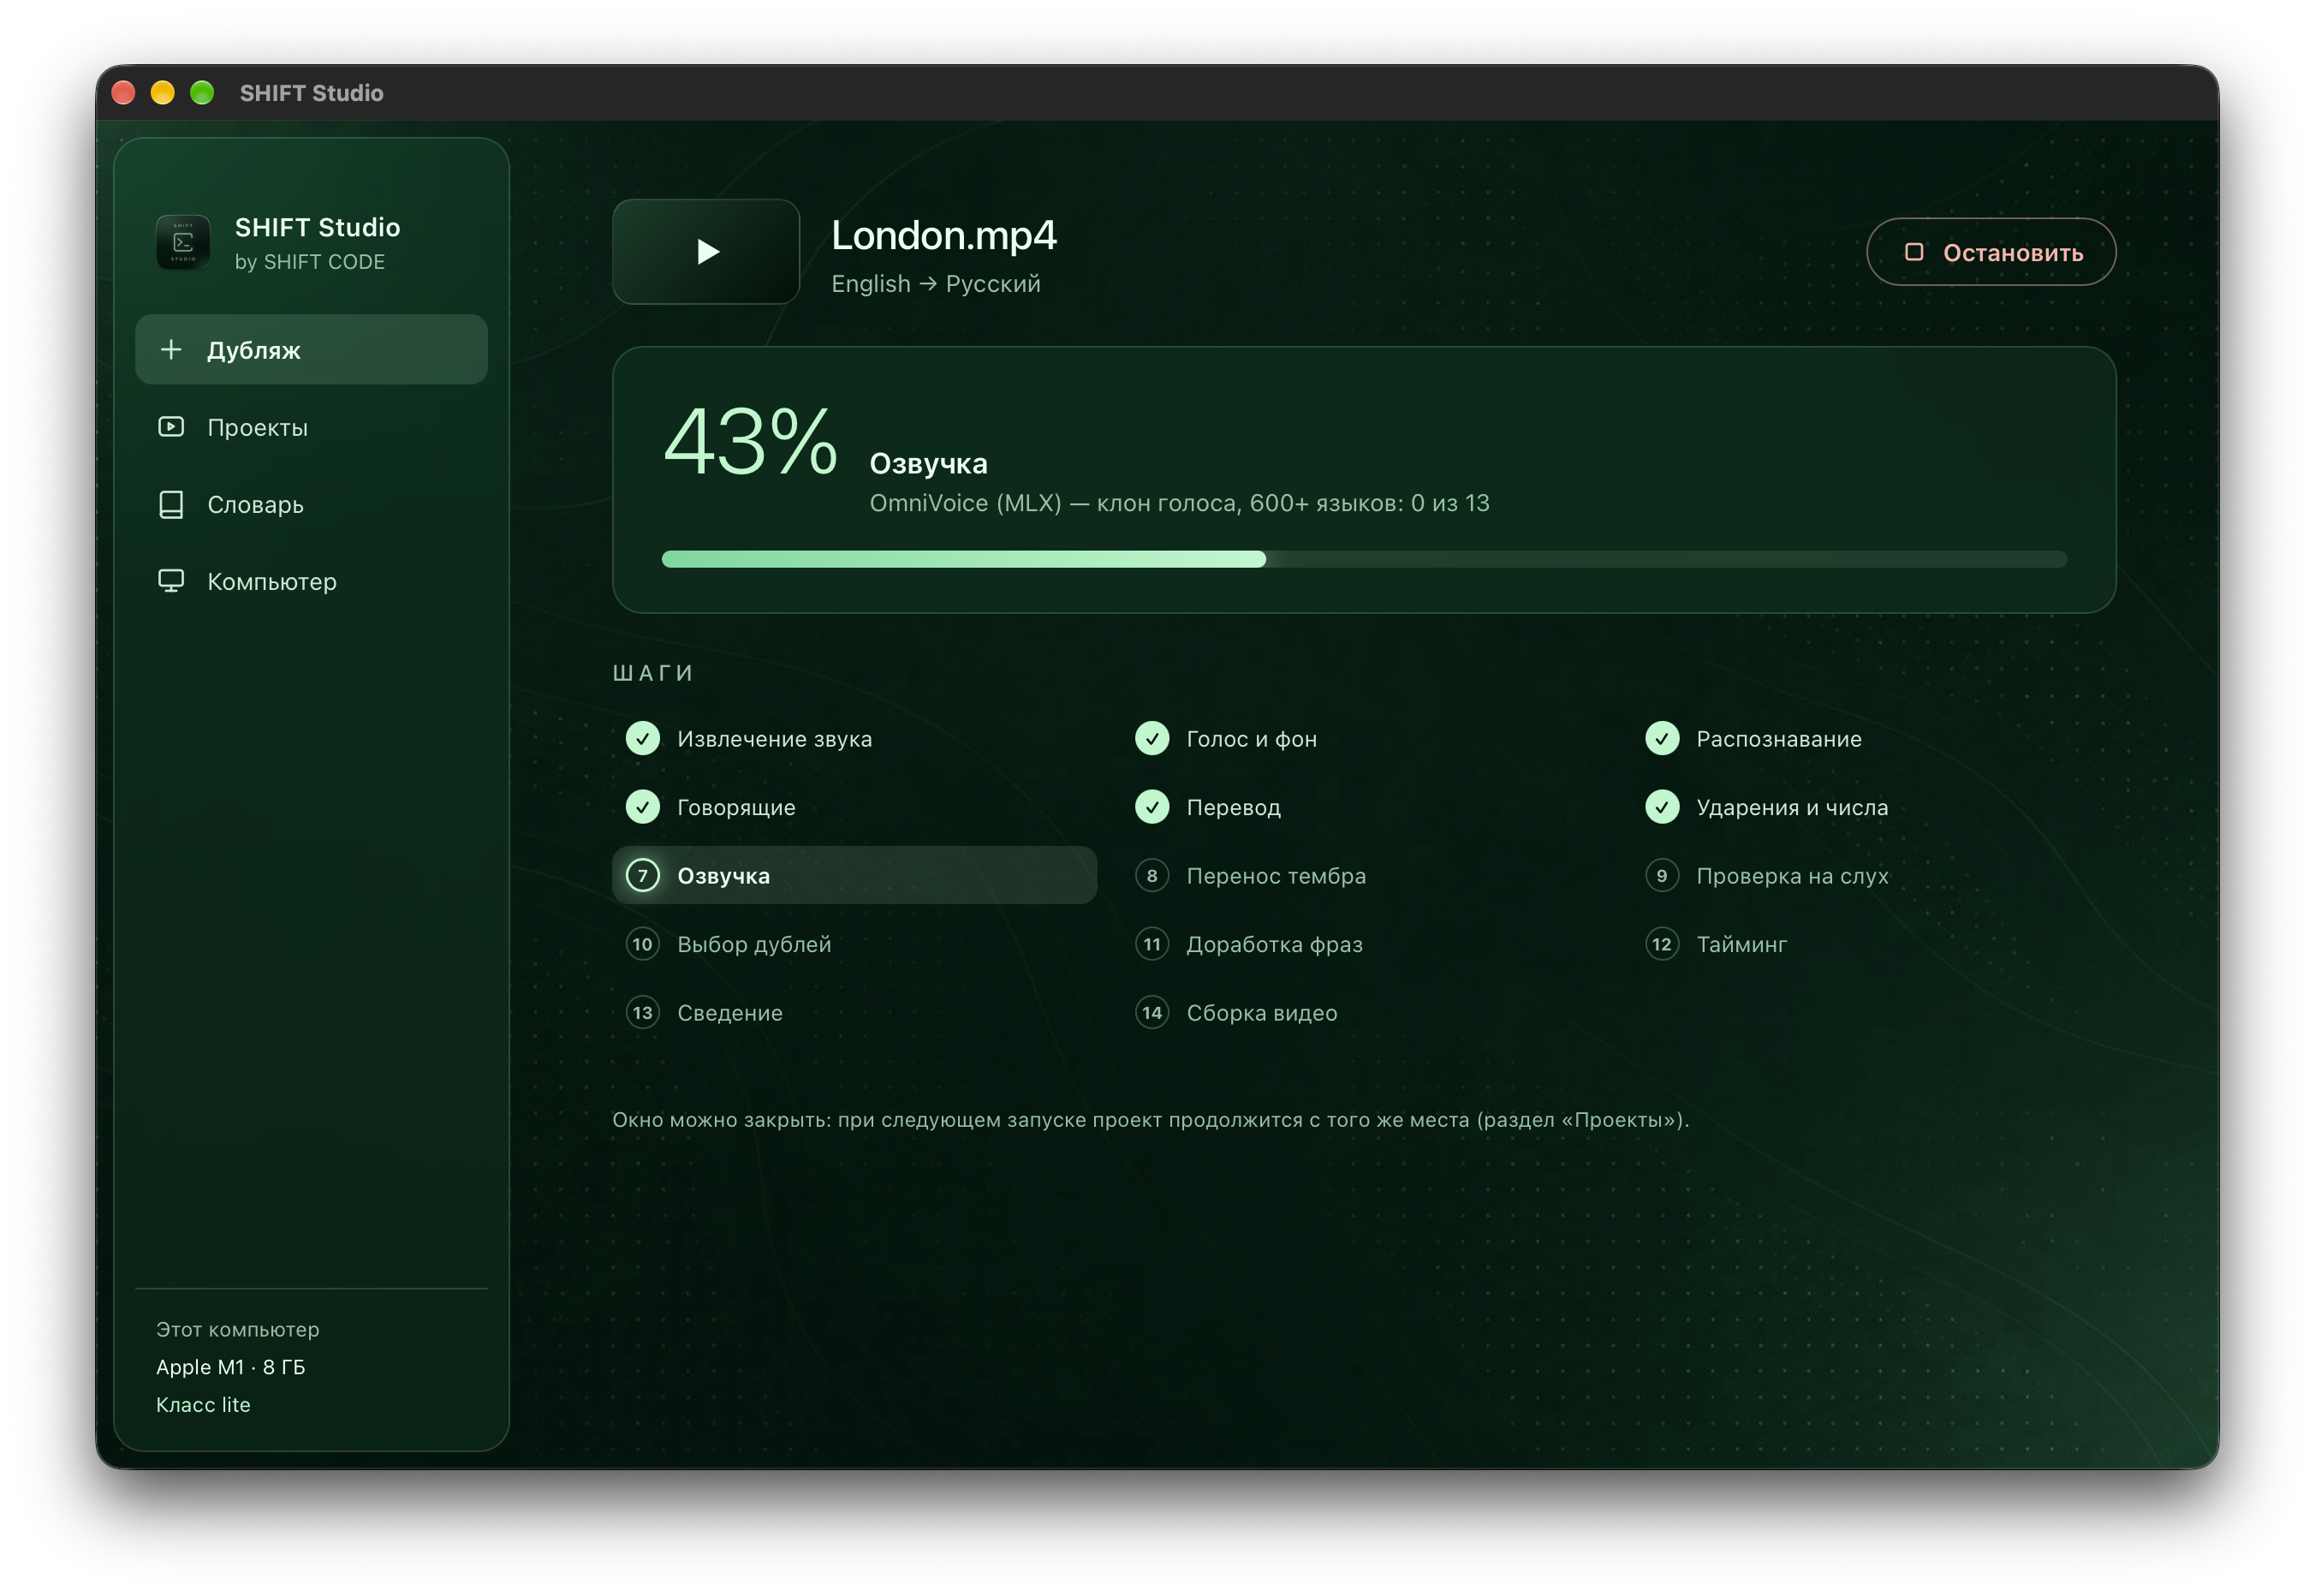
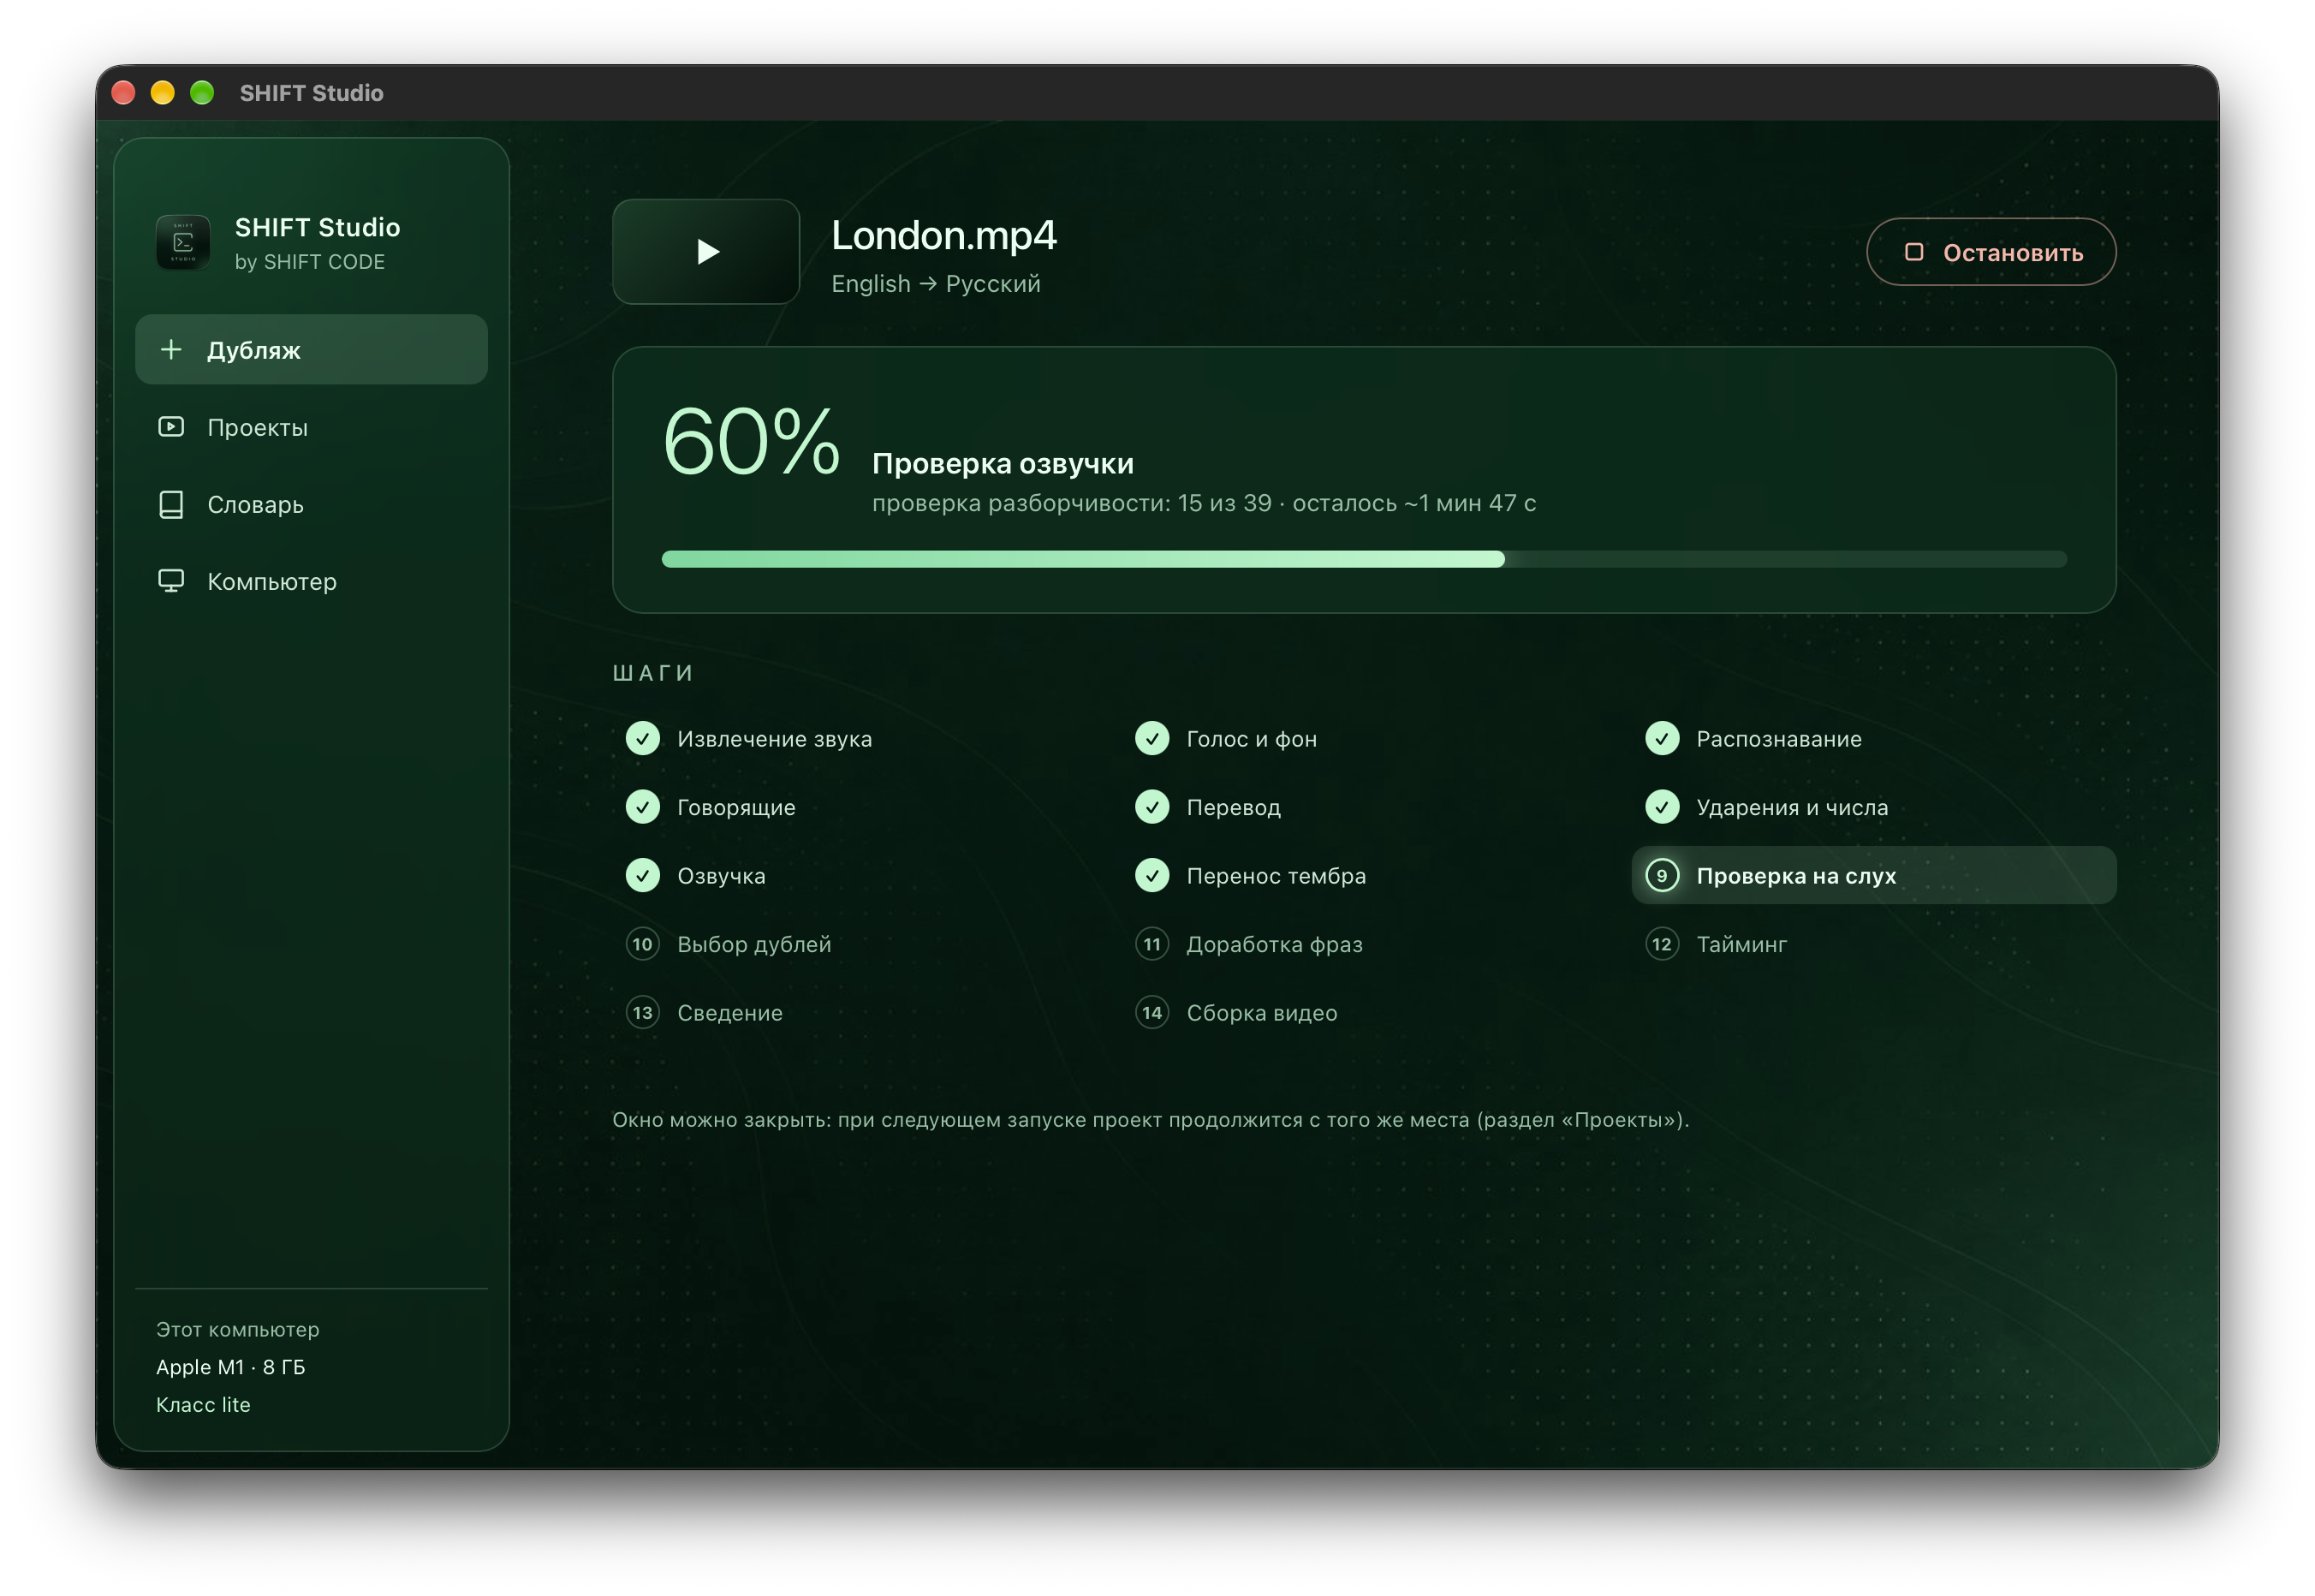
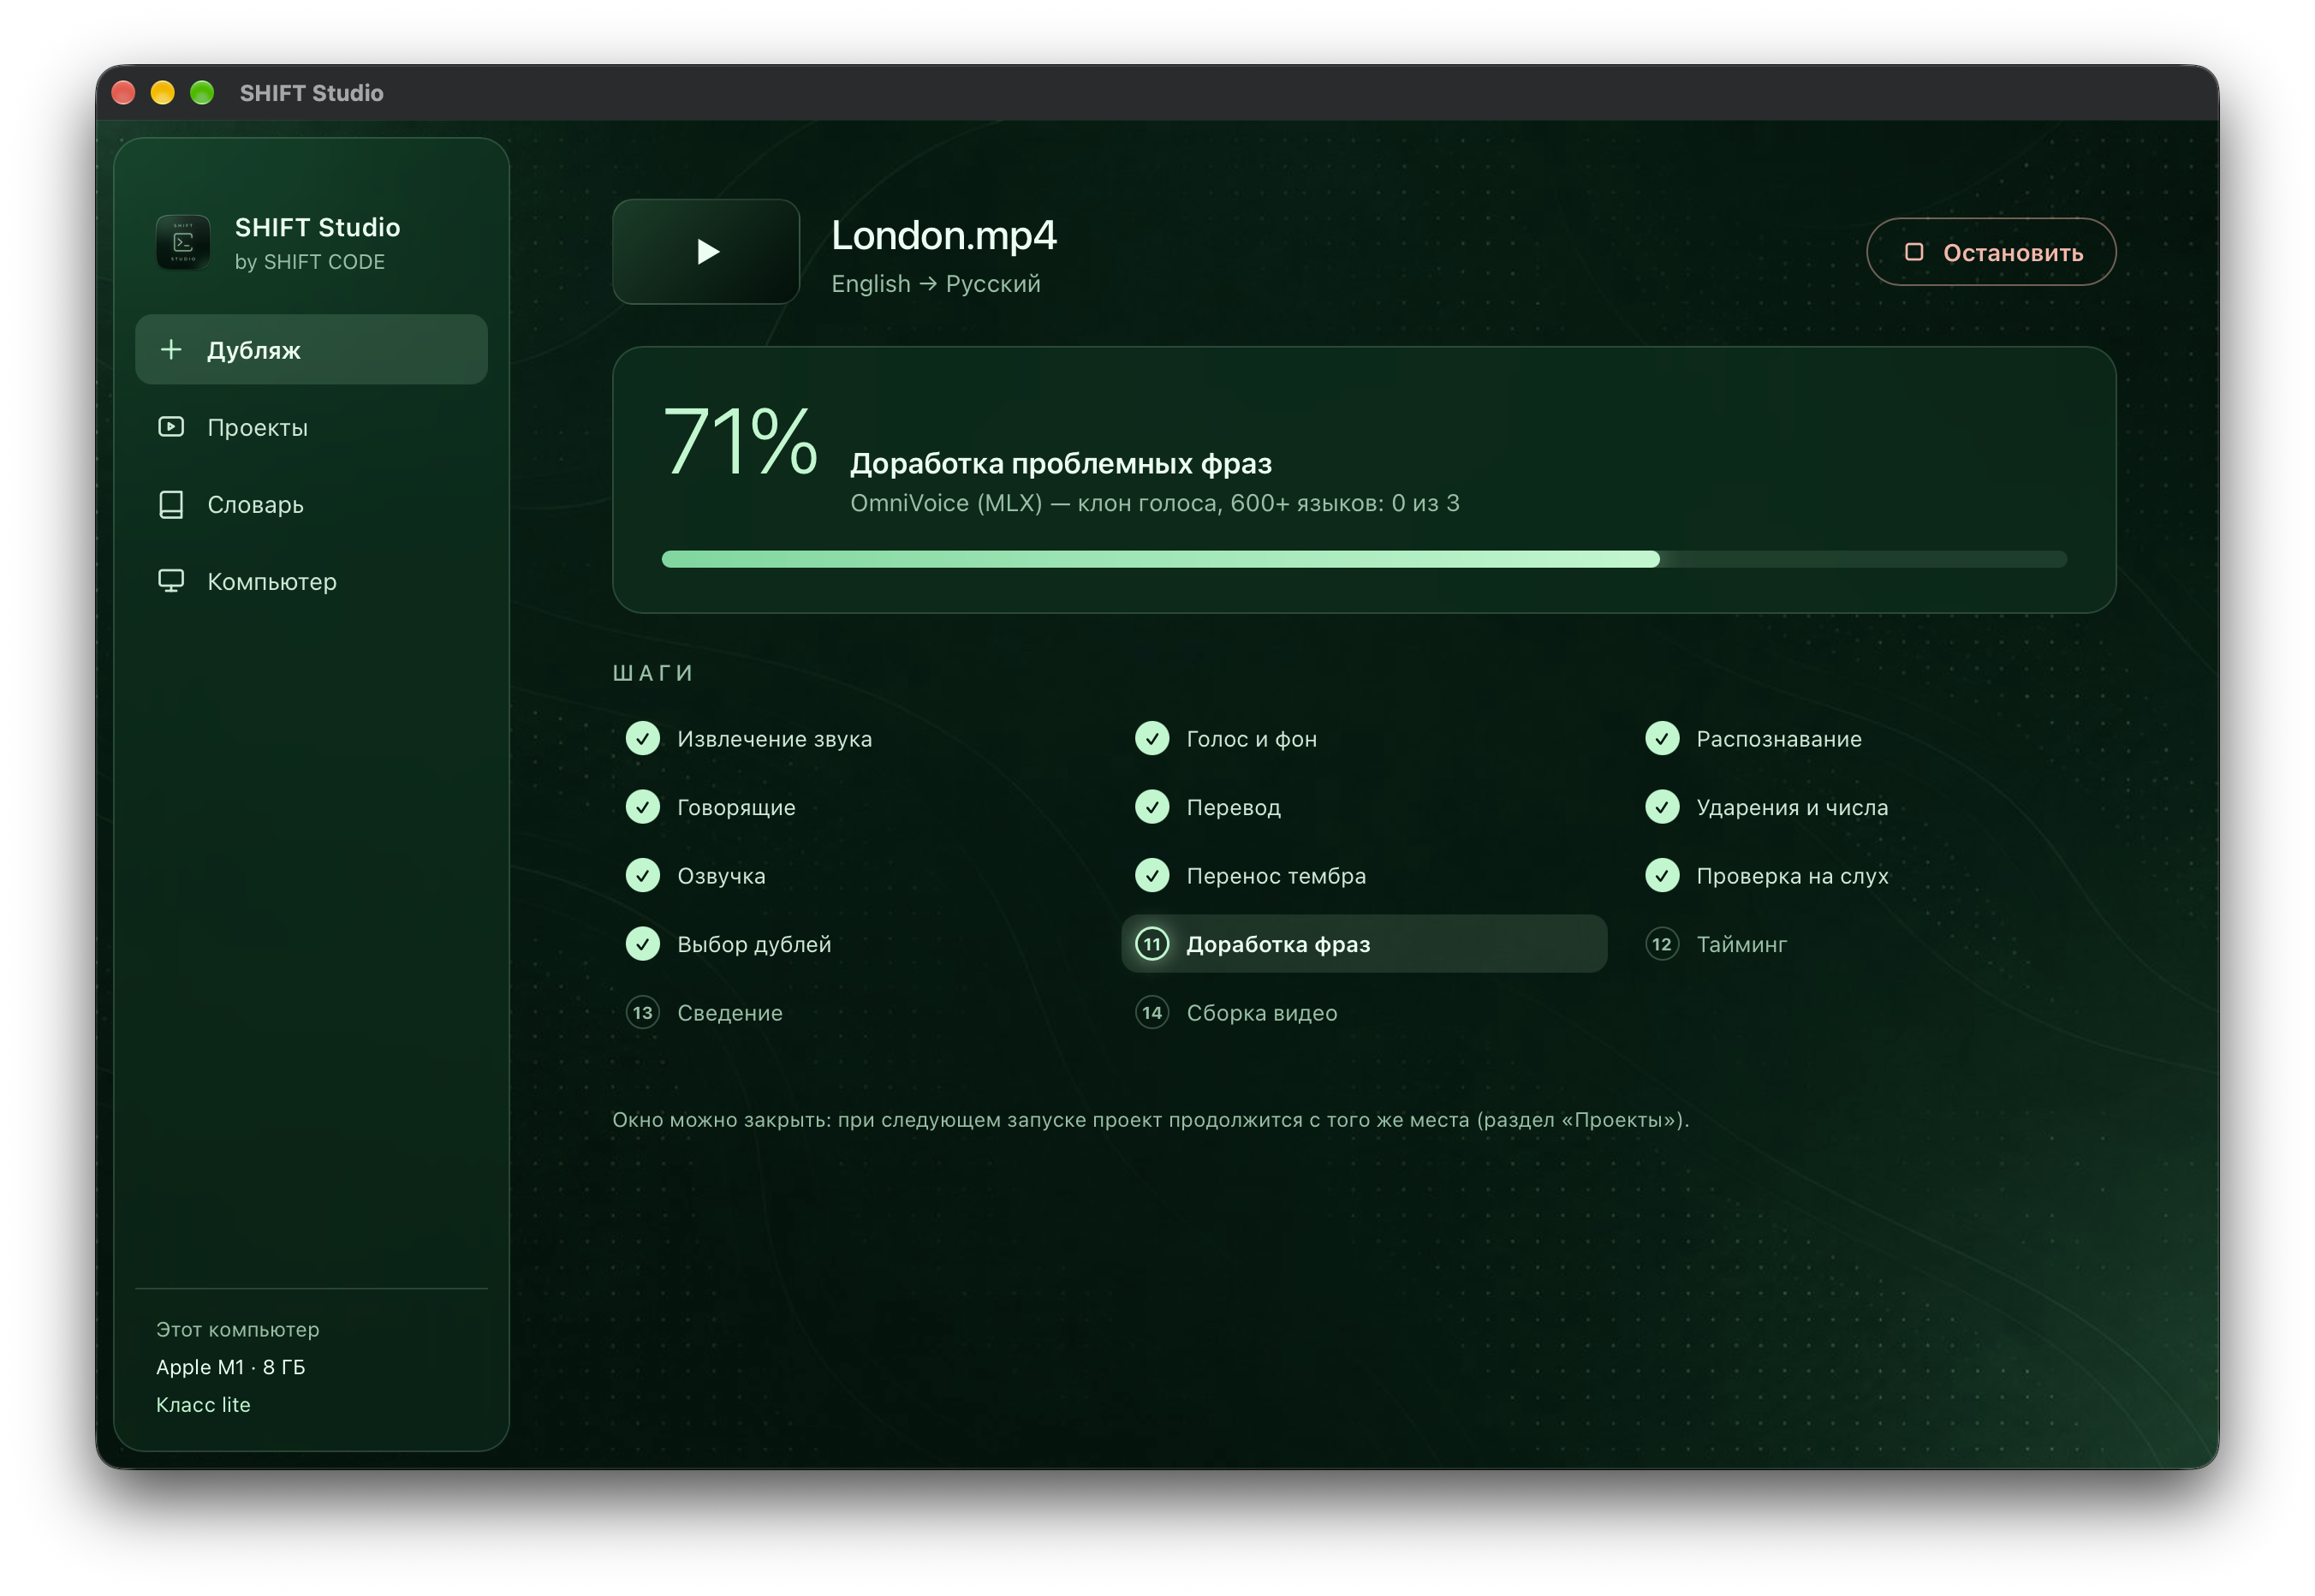
Внутри работает конвейер из тринадцати шагов. Звук извлекается из видео, голос отделяется от фона, речь распознаётся с таймкодами каждого слова и делится по говорящим, затем переводится с учётом контекста и длины фразы, получает правильные ударения и озвучивается. Каждая фраза синтезируется в нескольких вариантах разными движками, каждый вариант распознаётся обратно и сравнивается с текстом, а голос - с оригиналом. Программа сама выбирает лучший дубль, переозвучивает невнятные фразы и сокращает слишком длинные, подгоняет тайминг под паузы оригинала и сводит громкость с фоном. При желании перевод можно поправить перед озвучкой, а любую фразу прослушать и переозвучить отдельно. Каждый шаг выполняется в отдельном процессе, и модель полностью выгружается из памяти после работы, поэтому даже на компьютере с 8 ГБ можно использовать модели, которые вместе в память никогда бы не поместились. Всё работает офлайн: интернет нужен только один раз, чтобы скачать модели.
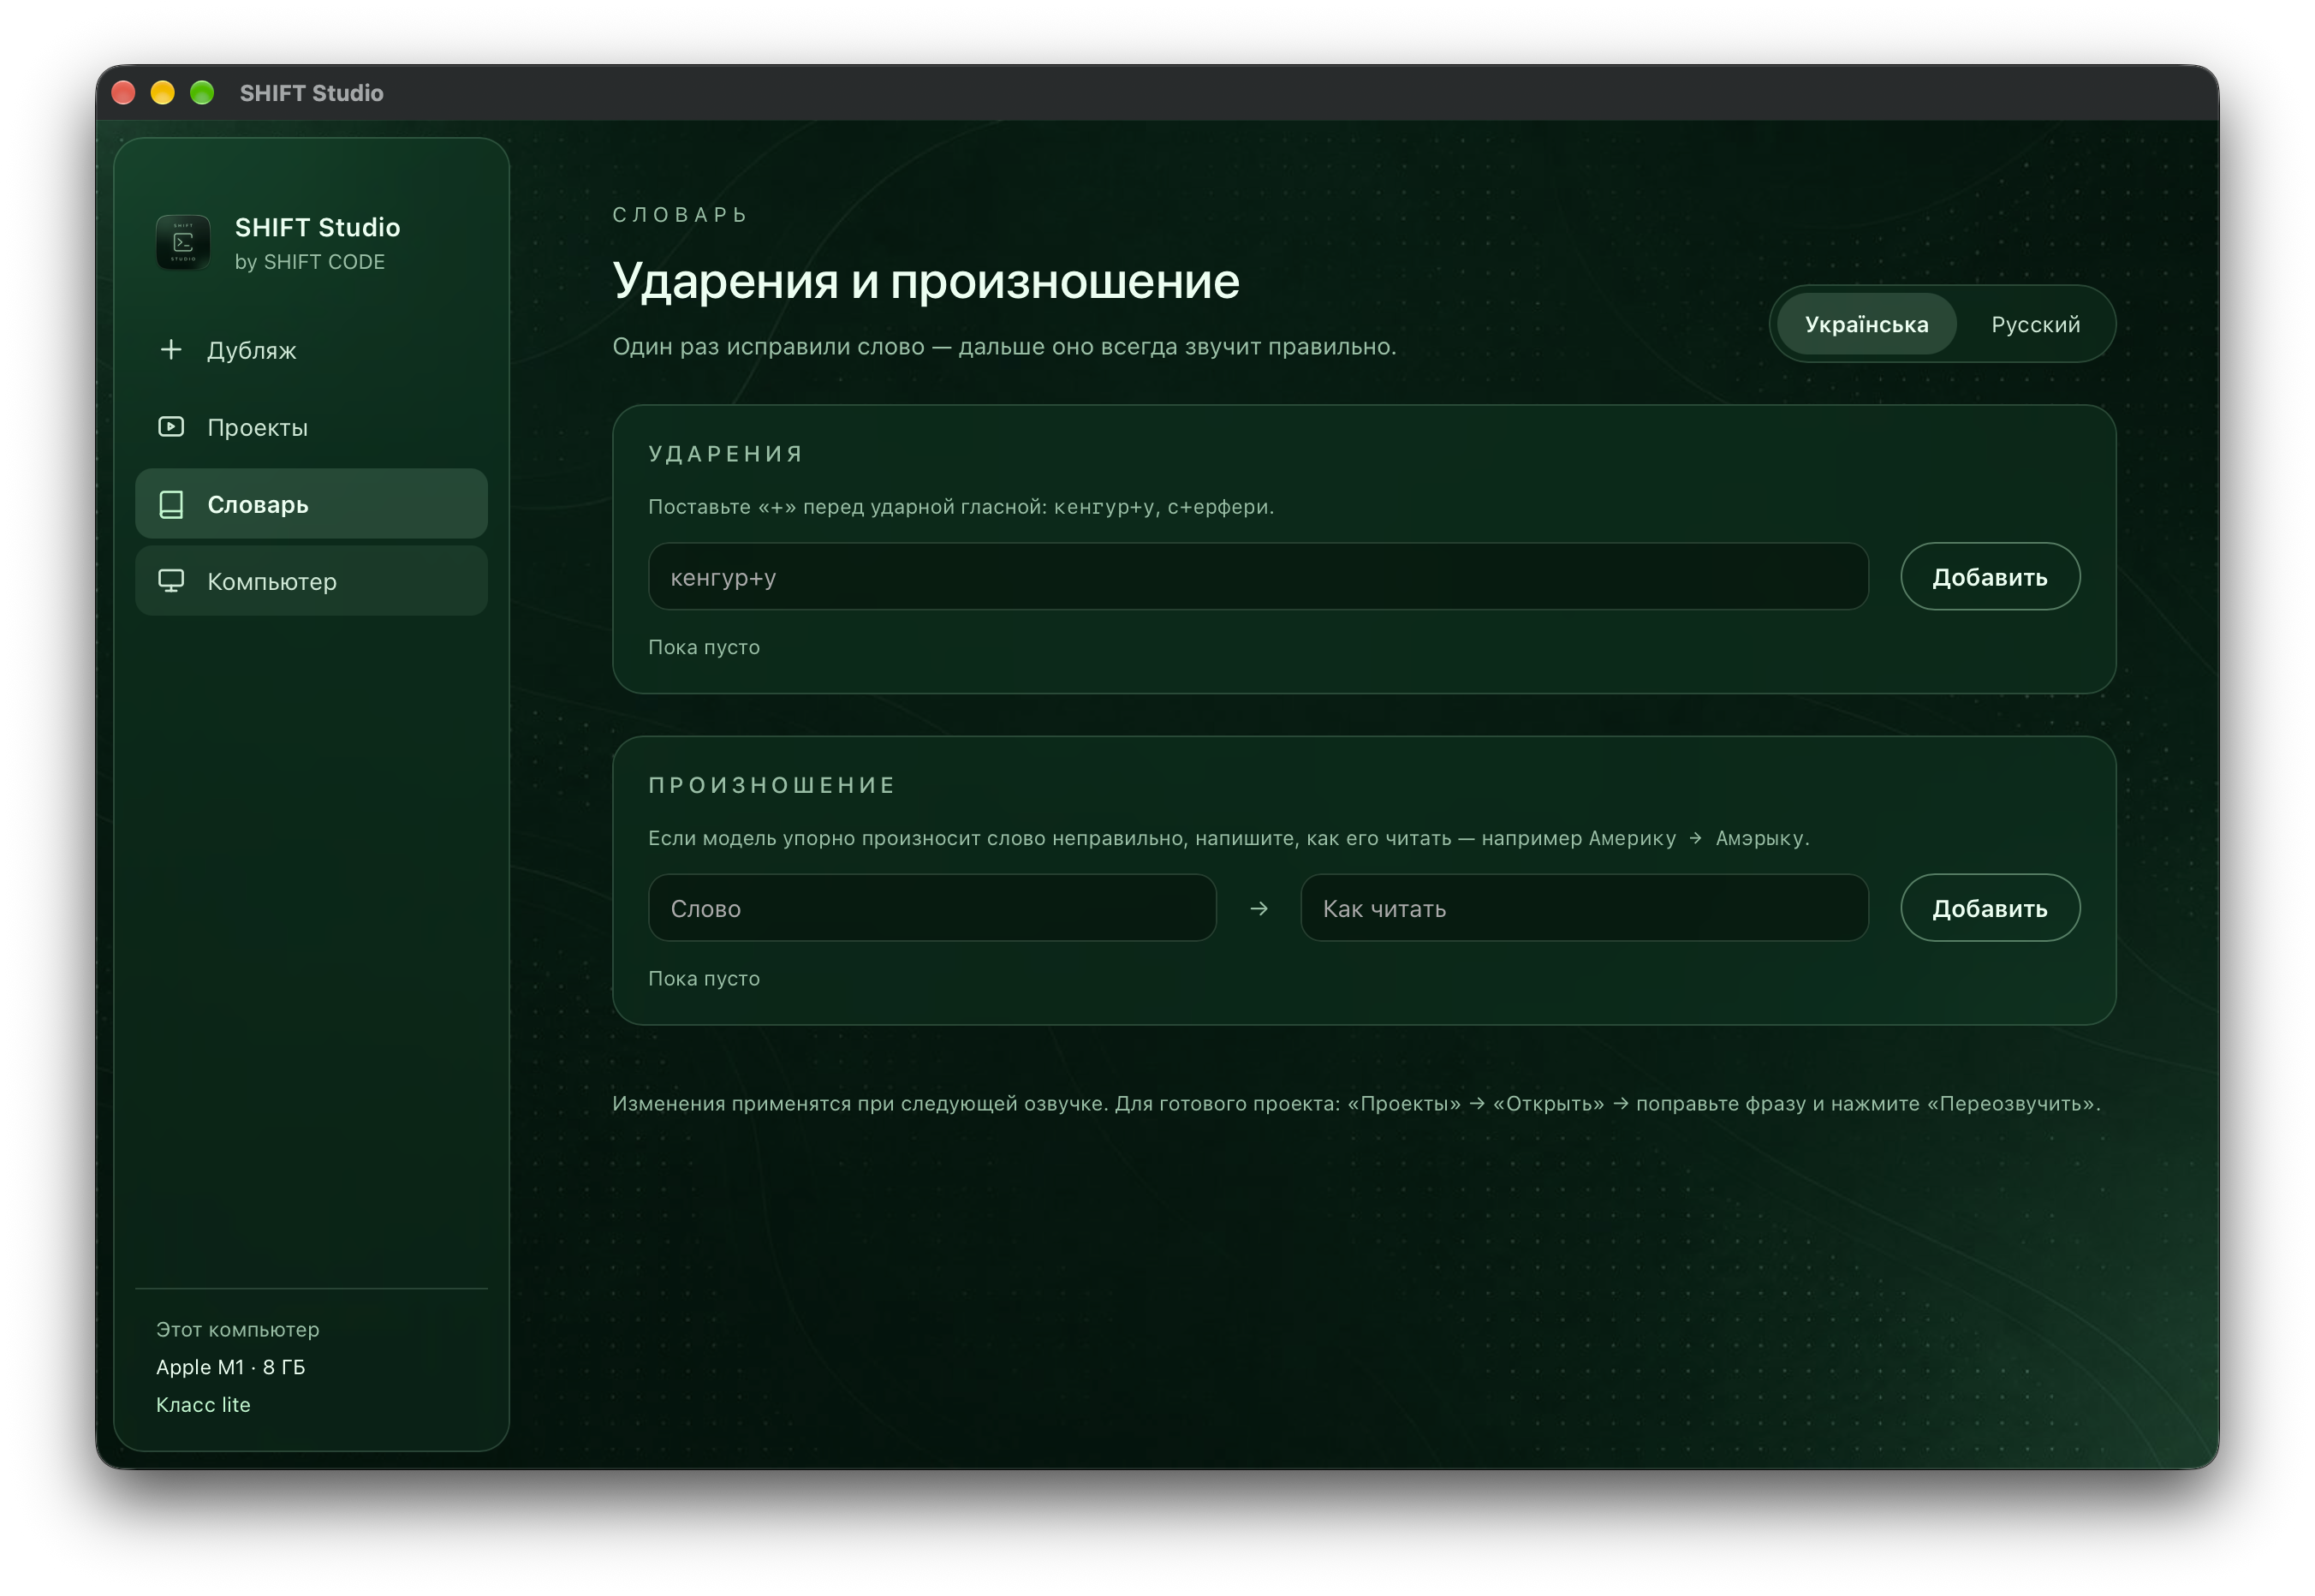
Для отделения голоса используется Demucs, для распознавания речи и проверки озвучки - Whisper large-v3 и large-v3 turbo, для определения говорящих - ECAPA-TDNN из SpeechBrain. Перевод выполняют языковые модели Gemma 3 и Qwen3 или NLLB-200, ударения расставляют RUAccent и ukrainian-word-stress. Голос синтезируют OmniVoice, KugelAudio, XTTS-v2 и Silero, а тембр переносит kNN-VC. Все модели описаны в расширяемом каталоге, поэтому новую модель можно добавить одной записью, и программа сама решит, подходит ли она компьютеру пользователя.
Программа написана на Python. Нейросетевая часть построена на PyTorch, Hugging Face Transformers и SpeechBrain; на Mac вычисления ускоряются через Apple MLX с 4-битными языковыми моделями, на Windows - через CUDA на видеокартах NVIDIA. За обработку звука и видео отвечают ffmpeg, Rubber Band и librosa. Настольное приложение сделано на pywebview с интерфейсом на HTML, CSS и JavaScript в фирменном стиле SHIFT CODE, есть и полноценная командная строка. Установщики написаны на Bash и PowerShell с менеджером окружений uv, а весь конвейер покрыт тестами на pytest.
В результате получилось кроссплатформенное приложение, которое само подбирает и устанавливает более 25 нейросетевых моделей под конкретный компьютер, работает полностью локально и делает дубляж между 12 языками в одно действие.